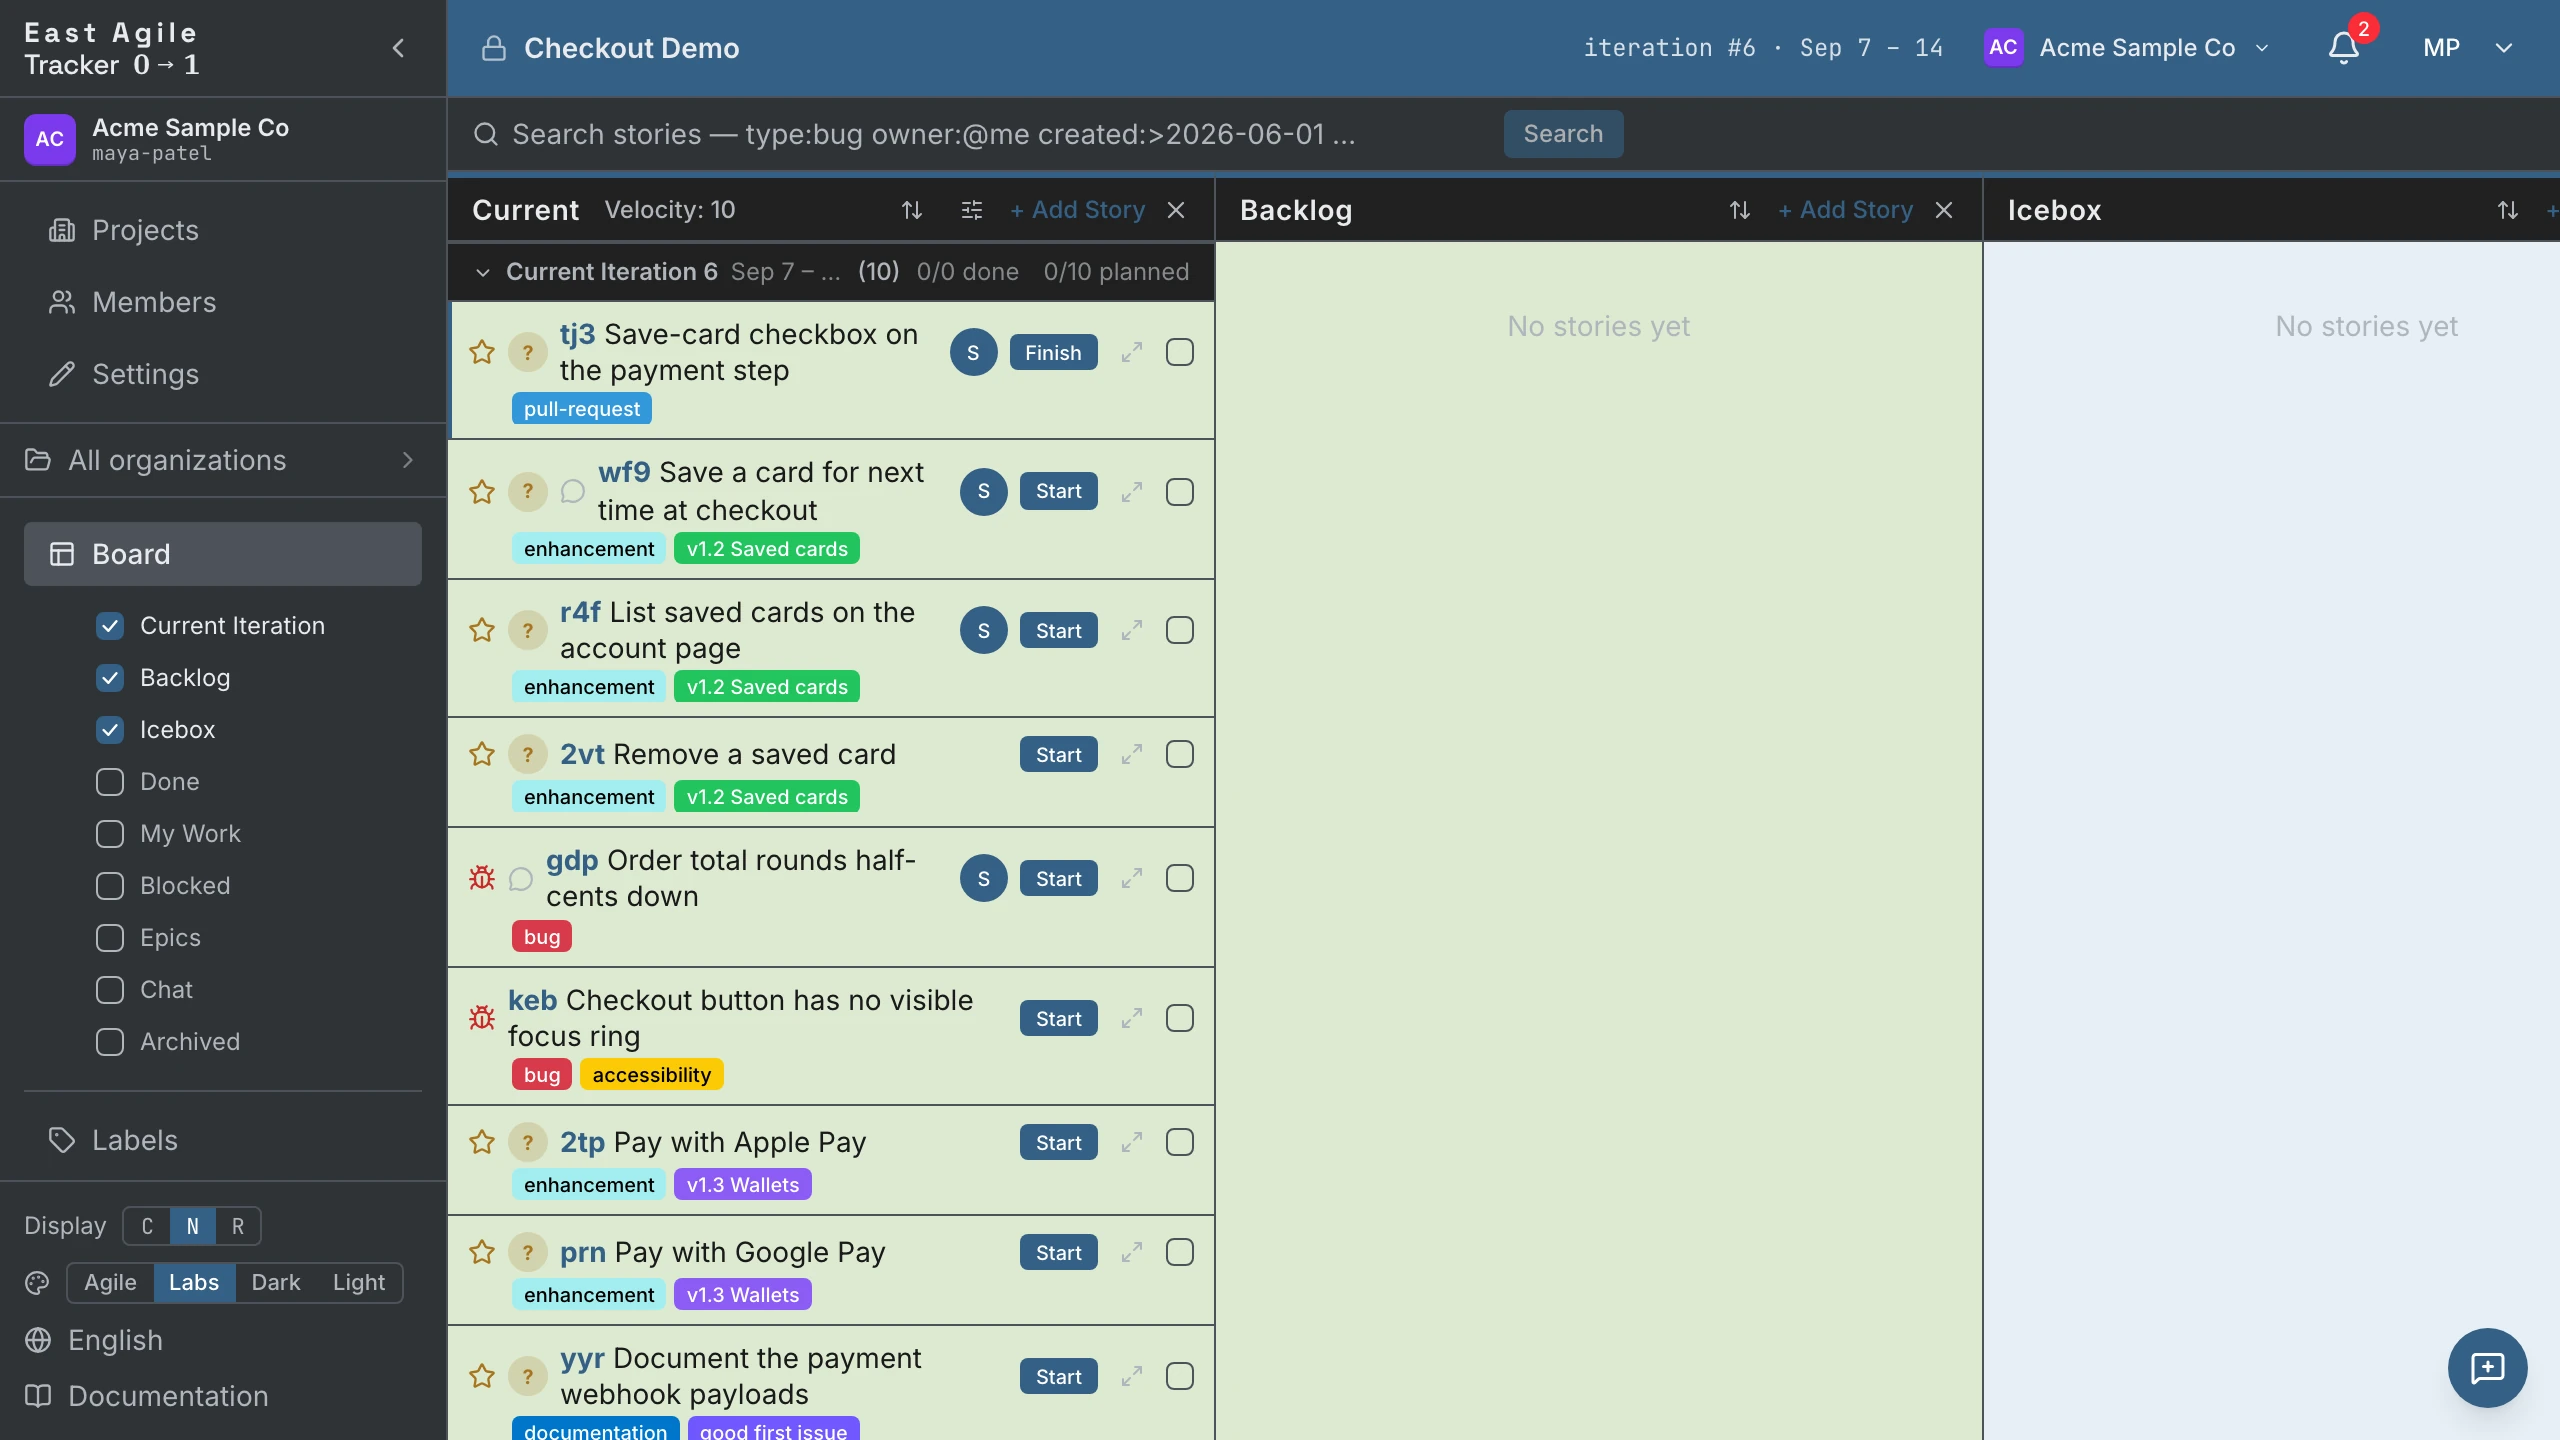
Skieruj agenta na repozytorium GitHub, a dostaniesz działającą tablicę: każde issue jako story, w stanie, który wynika z jego historii, z przeniesionymi listami zadań, etykietami i kamieniami milowymi. Potem ten sam agent podnosi story, przejmuje je, przeprowadza przez maszynę stanów i podpina pull requesta, którego otworzył.
Ta strona opisuje całą tę pętlę. Krok zapełniania ma dwie drogi: GitHub-to-EAT, otwartoźródłowy importer East Agile, robi to jednym poleceniem (krok 3); API importu wykonuje tę samą pracę wywołanie po wywołaniu (kroki 4 i 5), i właśnie tym steruje agent, gdy chce uchwyt zadania. Wszystko dalej idzie przez API, bo cały sens polega na tym, że resztę agent zrobi bez nadzoru.
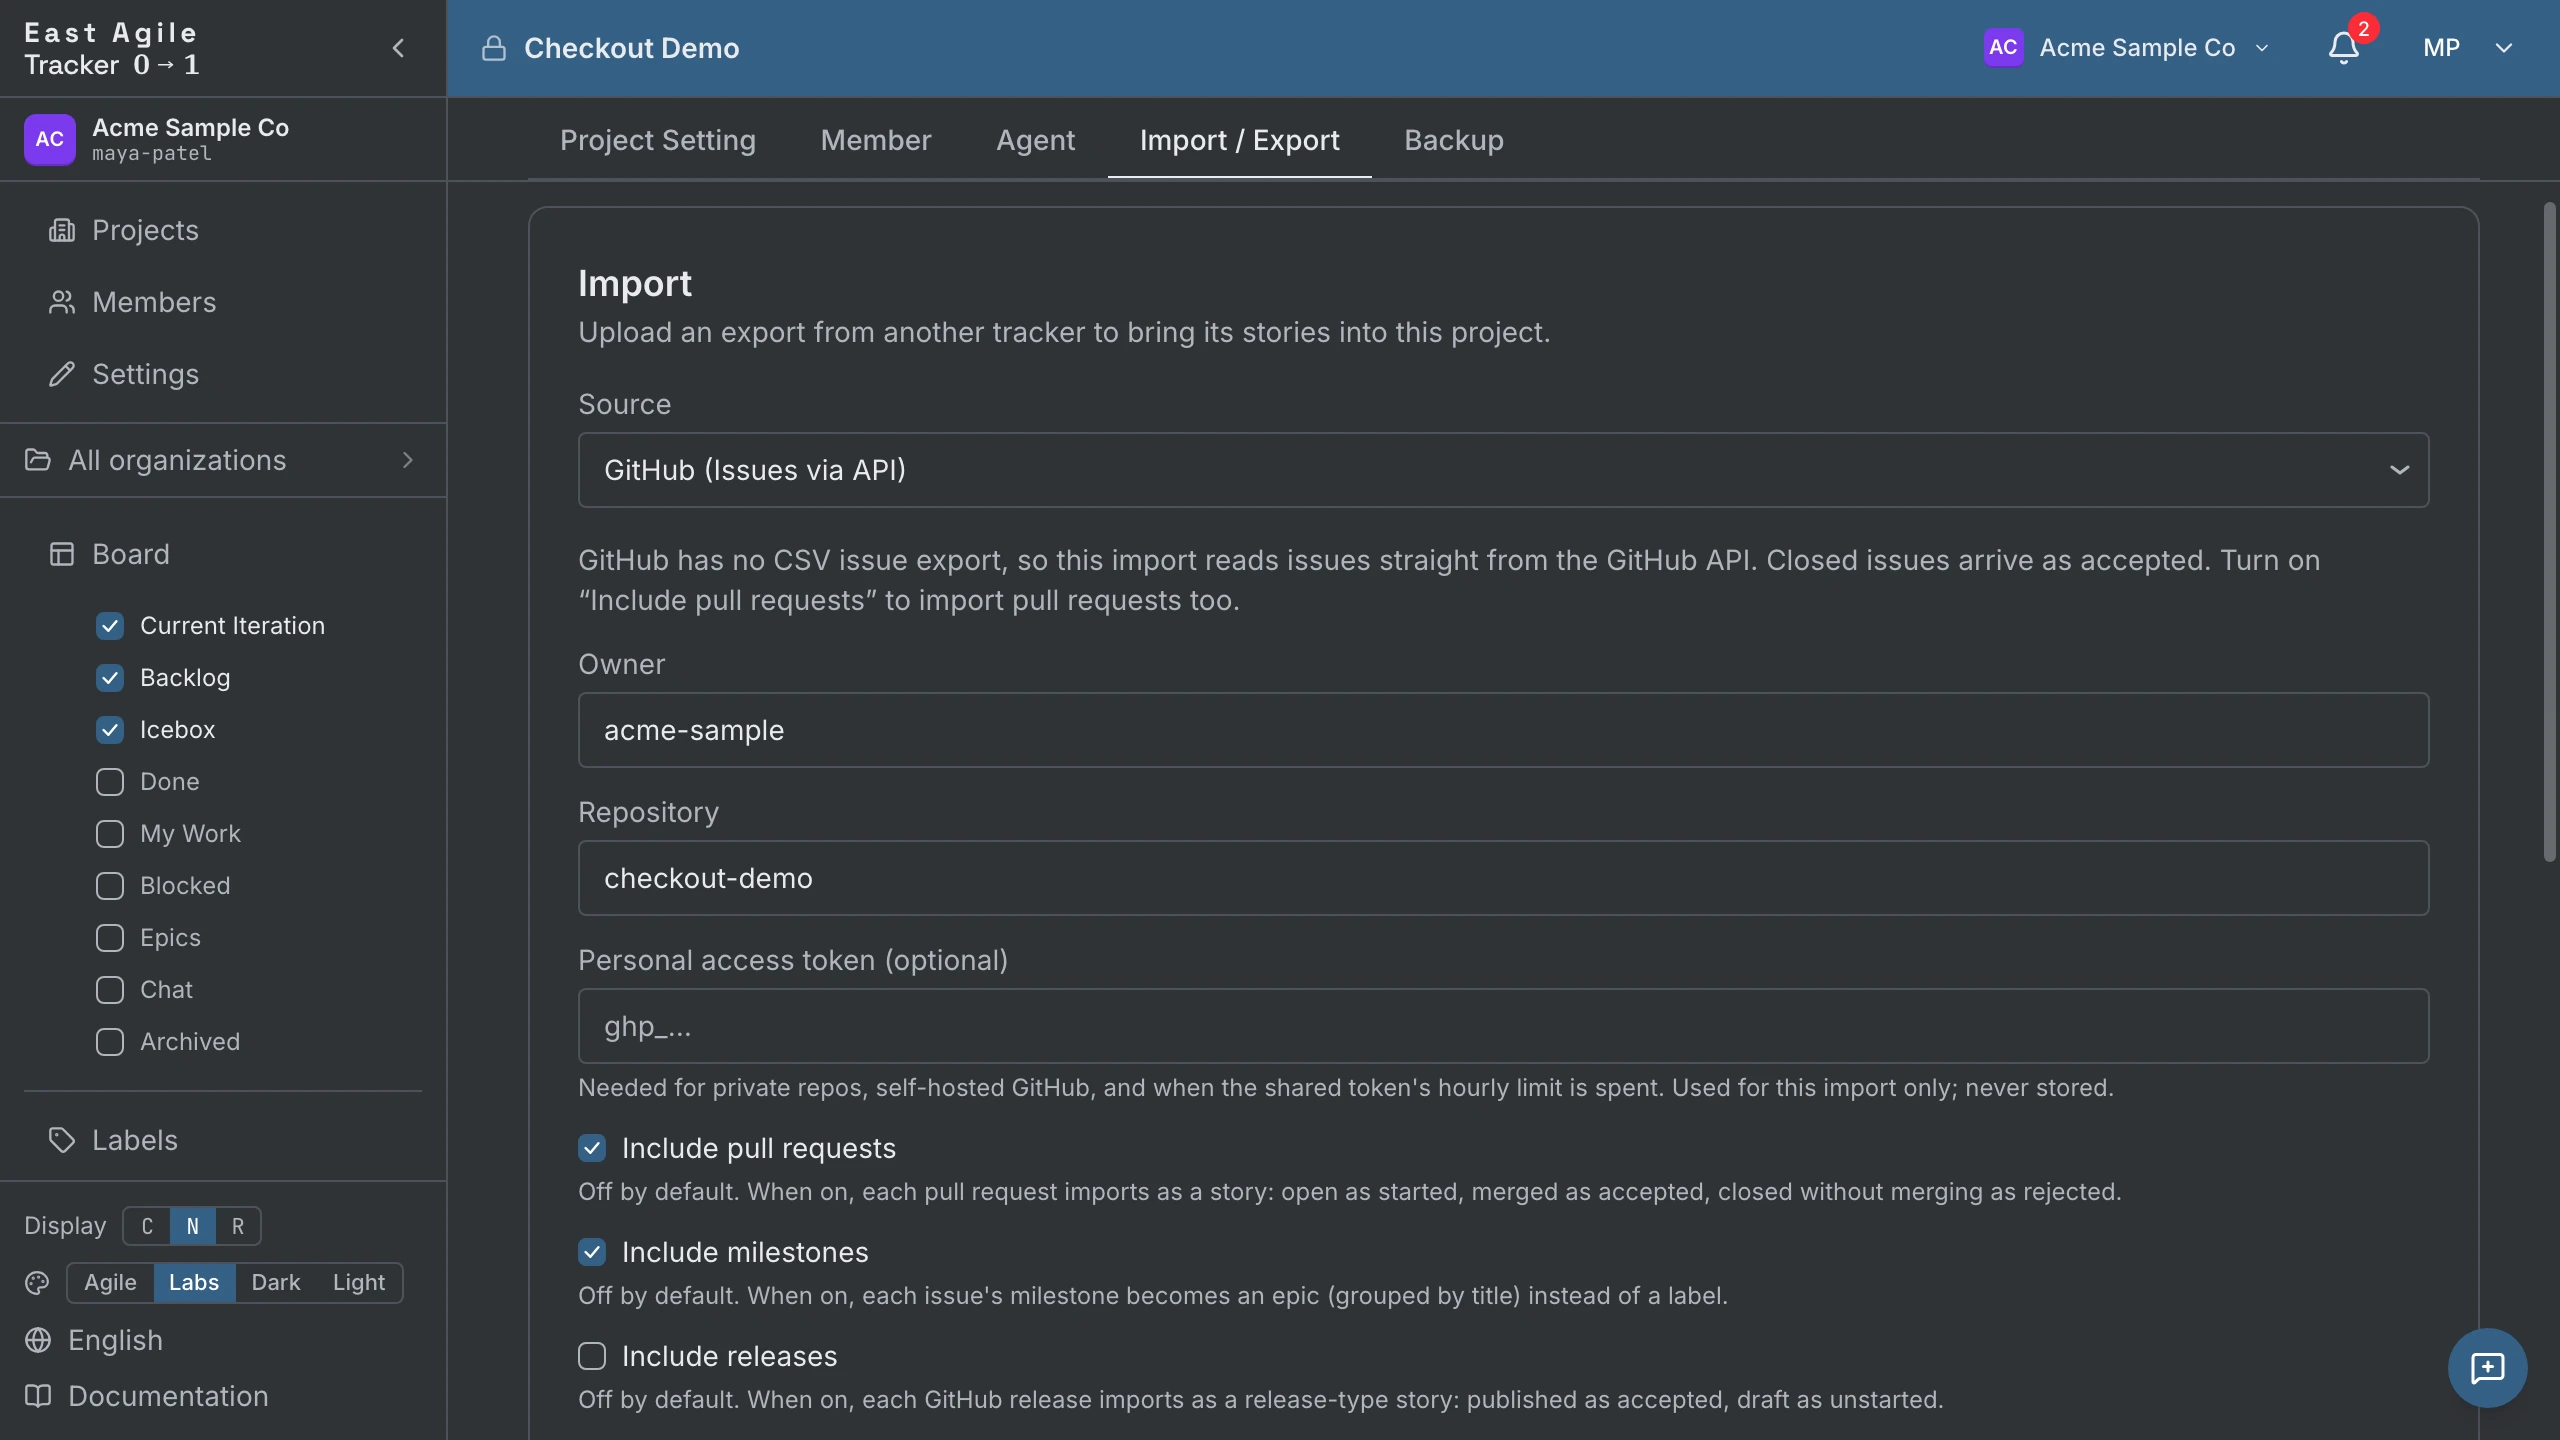
To nie jest osobny „import przez AI”. Krok zapełniania to ten sam importer GitHuba, który uruchomisz ręcznie w Ustawienia projektu → Import / Eksport, opisany w Instrukcja obsługi → Import z innych trackerów. Agent wywołuje ten sam endpoint co ty. To, co ta strona dokłada, to wszystko dookoła: kto trzyma klucz, jak sprawdzić import, zanim cokolwiek zapisze, i co agent robi z tablicą, gdy już istnieje.
Czego potrzebujesz
Dział zatytułowany „Czego potrzebujesz”- Projektu — oraz sesji albo klucza
ea_user_…, którym go założysz. - Klucza agenta — klucza
ea_agent_…ograniczonego do tego projektu. Jakiej roli potrzebuje, zależy od tego, jak dużą część pętli ma prowadzić agent; zobacz krok 2. Zobacz też Przewodnik API → Dwa rodzaje kluczy. - Osobistego tokenu dostępu GitHuba — z prawem odczytu issues repozytorium. Każdy import się uwierzytelnia, bo pobieranie idzie przez API GraphQL GitHuba, a GraphQL odrzuca żądanie bez tokenu. Możesz go pominąć tylko wtedy, gdy pobiera za ciebie Tracker: repozytorium publiczne, na wdrożeniu, które ma współdzielony token zapasowy (hostowane eastagiletracker.com ma taki; instalacja własna nie ma żadnego, dopóki jej operator nie ustawi
GITHUB_IMPORT_PAT), i nigdy z--engine directw GitHub-to-EAT. Zobacz Tokeny i limity zapytań. - Node.js 22+ — tylko dla drogi przez GitHub-to-EAT w kroku 3. Droga przez API nie potrzebuje niczego poza
curl.
1. Załóż projekt
Dział zatytułowany „1. Załóż projekt”Projekt musi istnieć przed kluczem agenta i musi go założyć człowiek: klucze agenta są przy wydaniu wiązane z jednym projektem i same projektu nie utworzą. Zrób to w interfejsie albo własnym kluczem ea_user_…:
curl -X POST https://eastagiletracker.com/api/v1/projects \ -H "X-TrackerToken: $TRACKER_USER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"name": "hello-world", "iteration_length_weeks": 1}'Odpowiedź niesie project_id, którego potrzebuje każde wywołanie poniżej.
2. Wydaj klucz agenta
Dział zatytułowany „2. Wydaj klucz agenta”Właściciel projektu tworzy klucze agenta w Ustawienia projektu → Agenci. Wybrana rola decyduje, ile z tej strony agent zrobi sam, a rozsądne odpowiedzi są dwie:
owner— jeden klucz przechodzi całą pętlę, razem z importem. Importować może tylko właściciel, bo import przepisuje kształt projektu w całości. Wydanie agenta z roląownerwymaga, żebyś sam był właścicielem projektu: rola agenta nigdy nie przekroczy roli jego twórcy.member— najmniejsze uprawnienie. Agent przejmuje stories, przesuwa je, komentuje i podpina pull requesty, ale nie umie importować. Import uruchamiasz sam (krok 5) własnym kluczem, a potem przekazujesz tablicę agentowi.
Tak czy inaczej nie zostawiaj wartości domyślnej. Nowy klucz agenta to viewer, dopóki nie powiesz inaczej, a viewer odczyta tablicę, ale nie przejmie ani nie przesunie story — czyli nie zrobi większości tej pętli.
Klucze agenta mają tu znaczenie wykraczające poza dostęp. Klucz agenta występuje jako nazwany uczestnik jednego projektu, więc każde story, które tworzy, każda zmiana stanu, którą wykonuje, i każdy komentarz, który pisze, są w historii przypisane temu agentowi — odróżnialne od twojej własnej pracy, a nie z nią zlane.
export TRACKER_TOKEN="ea_agent_xxxxx"Niech agent przeczyta /meta, zanim zrobi cokolwiek innego:
curl https://eastagiletracker.com/api/v1/meta \ -H "X-TrackerToken: $TRACKER_TOKEN"To odpowiada na dwa pytania, których agent inaczej by się domyślał: do jakiego projektu klucz jest przypisany (auth.project_id) i które zmiany stanu są dozwolone dla danego typu story (transitions). Feature idzie unstarted → started → finished → delivered → accepted; chore to tylko unstarted → started → accepted. Odczytanie mapy bije zaszycie jej na sztywno.
3. Import przez GitHub-to-EAT
Dział zatytułowany „3. Import przez GitHub-to-EAT”GitHub-to-EAT to własny otwartoźródłowy importer East Agile: narzędzie wiersza poleceń na licencji MIT, które robi cały krok zapełniania — kroki 4 i 5 poniżej — jednym poleceniem. Sięgnij po nie, gdy przy terminalu siedzi człowiek. Sięgnij po API pod spodem, gdy steruje agent bez nadzoru i chce uchwyt zadania do odpytywania.
Wymaga Node.js 22+ i nie ma własnych zależności czasu wykonania. Nie jest jeszcze opublikowane w npm, więc zainstaluj je z repozytorium:
git clone git@github.com:EastAgile/GitHub-to-EAT.gitcd GitHub-to-EATnpm install --global .Potem skieruj je na klucz wydany w kroku 2 i projekt założony w kroku 1:
export EAT_AGENT_KEY="ea_agent_xxxxx"github-to-eat --project $PROJECT_ID --repo octocat/hello-worldNajpierw wypisuje legendę mapowania — dokładnie jak wyląduje każdy wybrany typ — i prosi o potwierdzenie, zanim cokolwiek zapisze. Poza terminalem, w potoku, w CI albo w agencie nie ma gdzie pokazać tego pytania, więc uruchomienie, które by zapisywało, musi przekazać --yes; bez tego narzędzie kończy kodem 2 i nic nie zapisuje, zamiast zgadywać twoją odpowiedź. Ponowne uruchomienie jest bezpieczne: to, co już zaimportowano, zostaje pominięte, nigdy zduplikowane.
| Flaga | Co robi |
|---|---|
--dry-run | Kontrola wstępna, potem wypisanie planu, który by wykonała — ile stories by zaimportowała, ile pominęła jako już obecne — i nic nie zapisuje. Nie wymaga --yes. |
--include | Które typy importować, po przecinku: issues,prs,milestones,releases,deps. Domyślnie issues, a każdy wybór musi je zawierać. To te same opcje co tabela w kroku 6. |
--token | Twój osobisty token dostępu GitHuba (liczy się też GITHUB_TOKEN w środowisku albo w .env). Potrzebuje repo albo drobnoziarnistego Issues: Read na tym repozytorium. Wymagany dla repozytorium prywatnego, dla serwera bez współdzielonego tokenu zapasowego i zawsze dla --engine direct. Pomiń go na domyślnym silniku usługi hostowanej, a Tracker wyda własny współdzielony budżet — zobacz Tokeny i limity zapytań. |
--engine | server, domyślny, wysyła jedno wywołanie /import/json i pozwala Trackerowi pobrać, zmapować i zapisać. direct uruchamia ten sam potok na twojej maszynie i zapisuje przez publiczne API — czyta więc GitHuba sam i zawsze potrzebuje tokenu, inaczej kończy kodem 2. |
--states, --milestones, --story-type, --no-comments, --no-tasks | Zawężają lub nadpisują mapowanie na jedno uruchomienie; nic nie jest utrwalane. Każda z nich implikuje --engine direct. |
Ustaw EAT_API_BASE i EAT_APP_BASE, aby skierować je na własny lub lokalny Tracker; oba domyślnie wskazują usługę hostowaną. README niesie pełny wykaz flag, kody wyjścia i rozwiązywanie problemów.
Wszystko poniżej to ten sam import sterowany wywołanie po wywołaniu, czyli to, czego chcesz, gdy uruchamia go agent.
4. Najpierw przebieg próbny
Dział zatytułowany „4. Najpierw przebieg próbny”Import jest tylko dla właściciela — użyj klucza agenta z rolą owner albo własnego klucza, jeśli zostawiłeś agenta jako member. Uruchom go najpierw z dry_run, zanim pozwolisz mu cokolwiek zapisać:
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/import/json \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{ "source": "github", "owner": "octocat", "repo": "hello-world", "include_pull_requests": true, "include_milestones": true, "dry_run": true }'Przebieg próbny pobiera z GitHuba, rozwiązuje i deduplikuje dokładnie tak jak prawdziwy, raportuje te same liczby — imported, skipped, errors, unmatched — a potem wycofuje całą transakcję. Nic nie zostaje i żadne zdarzenie o zakończonym imporcie nie trafia do dziennika audytu. To najtańszy sposób, by odkryć, że chciałeś włączyć kamienie milowe albo że repozytorium jest większe, niż sądziłeś — dopóki nic cię to jeszcze nie kosztuje.
Każde wywołanie /import/json jest asynchroniczne, łącznie z przebiegiem próbnym: endpoint zwraca 202 z uchwytem zadania, a nie wynik, a liczby pojawiają się na zadaniu, gdy je odpytasz (krok 5). Zadanie przebiegu próbnego dochodzi do stanu done tak samo jak prawdziwe; różnica polega na tym, że nic nie zostało zapisane.
5. Uruchom import
Dział zatytułowany „5. Uruchom import”Usuń dry_run i wyślij ponownie. Tak jak poprzednio, endpoint zwraca 202 z uchwytem zadania:
{ "import_id": "…", "status": "pending" }Odpytuj zadanie, aż osiągnie stan końcowy:
curl https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/imports/$IMPORT_ID \ -H "X-TrackerToken: $TRACKER_TOKEN"Status idzie pending → fetching → writing → done | failed. Końcowe są tylko dwa ostatnie: done niesie liczby wyniku, failed niesie komunikat błędu i stabilny kod maszynowy, po którym można się rozgałęzić. Gdy pobieranie stronicuje, progress_current i progress_total mówią, na której stronie jest — warto to pokazać, jeśli patrzy człowiek.
Tokeny. Przekaż "token": "github_pat_…". Pomiń go, a serwer podstawi współdzielony token platformowy, który czyta tylko repozytoria publiczne i rozlicza się na wszystkich wywołujących w danym wdrożeniu — Tokeny i limity zapytań opisuje, co cię to kosztuje. Którykolwiek token zadziała, prowadzi wywołania w górę do GitHuba i nic więcej: nigdy nie trafia do logów, nigdy do dziennika audytu, nigdy nie jest przechowywany ani zwracany w odpowiedzi czy w błędzie.
Ponowne uruchomienie jest bezpieczne. Wiersz, który już zaimportowano, jest dopasowywany po identyfikatorze źródłowym i pomijany, a nie duplikowany. Drugi import uzupełnia tablicę o to, co pojawiło się od pierwszego.
6. Co ląduje na tablicy
Dział zatytułowany „6. Co ląduje na tablicy”Issues importują się domyślnie. Wszystko inne jest opcjonalne, po jednej fladze na typ:
| Z GitHuba | Staje się | Flaga |
|---|---|---|
| Issue | Story. Otwarte → unstarted w Backlogu. Zamknięte → accepted, albo rejected, gdy GitHub mówi, że issue zamknięto jako not_planned lub duplicate (story dostaje wtedy odpowiadającą etykietę). | domyślnie |
| Lista zadań w treści issue | Zadania — każdy wiersz - [ ] / - [x] staje się jednym zadaniem w kolejności z treści, a [x] przychodzi jako ukończone. Lista zostaje też w opisie. | domyślnie |
| Etykiety | Etykiety, przeniesione bez zmian. | domyślnie |
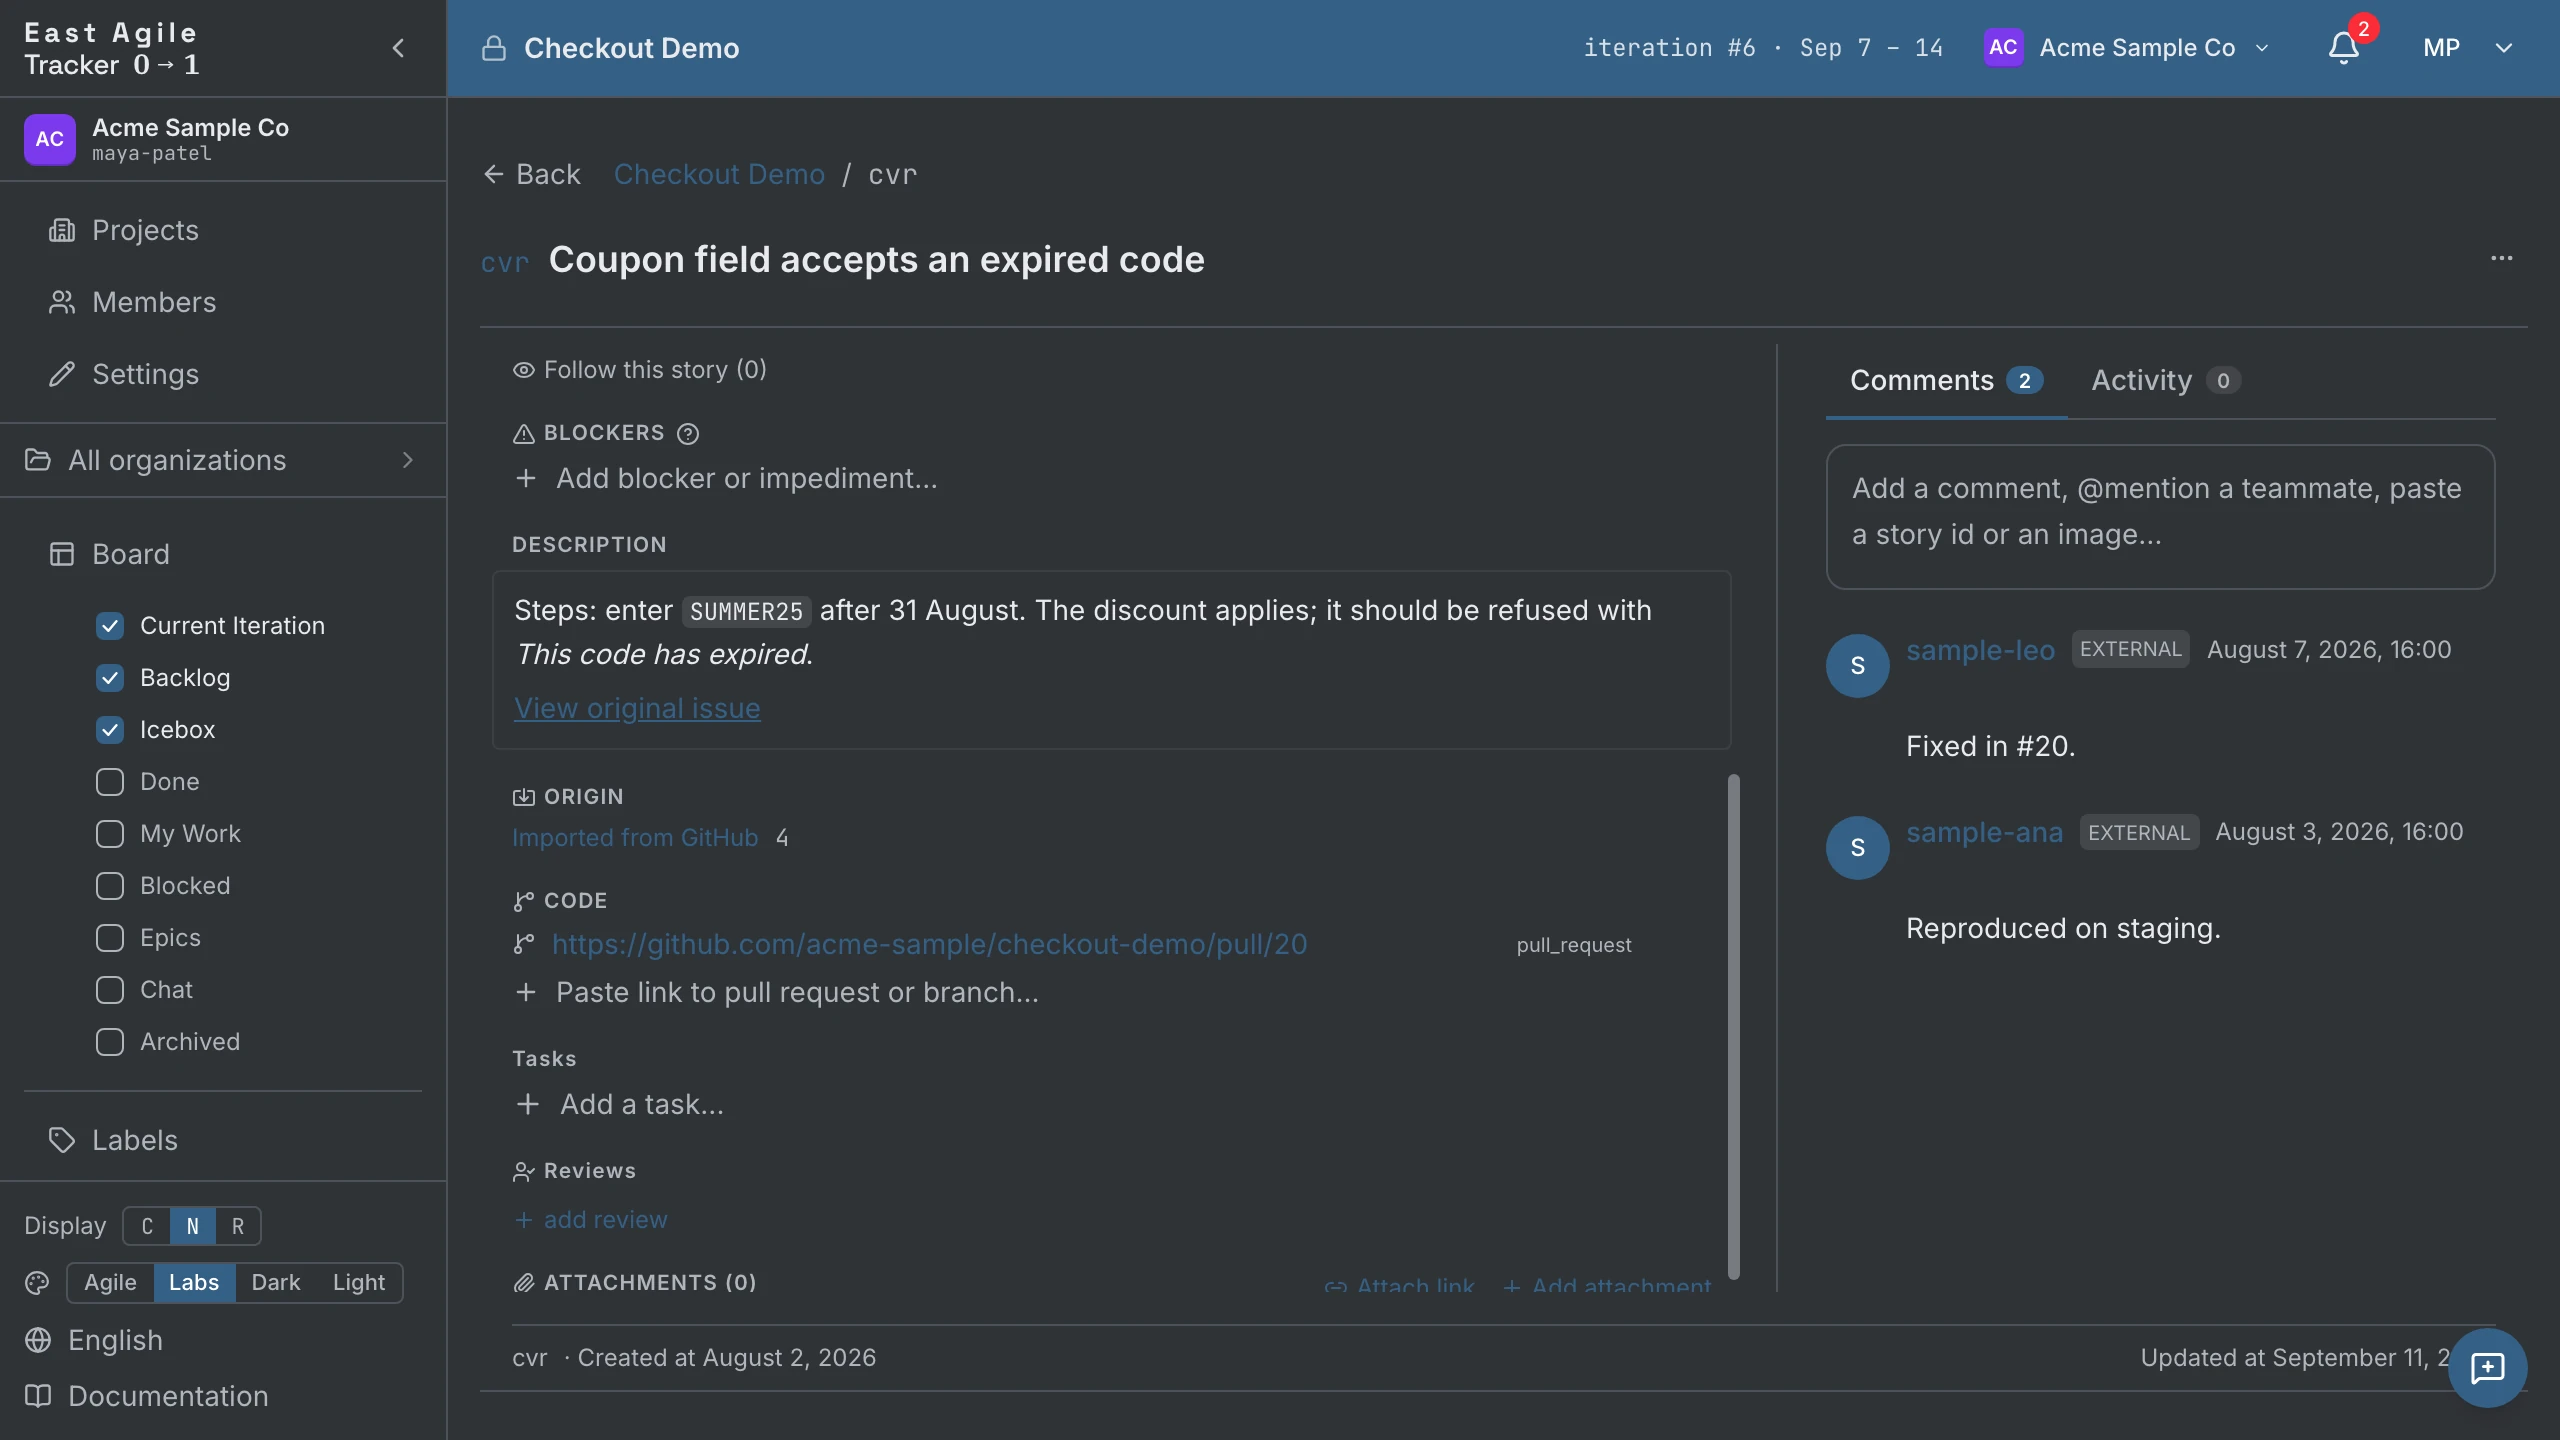
| Pull request | Story z etykietą pull-request. Otwarty → started, zmergowany → accepted, zamknięty bez merge’a → rejected. | include_pull_requests |
| Kamień milowy | Epik nazwany po kamieniu milowym i odduplikowany po tytule — dwa issues dzielące kamień milowy trafiają do jednego epiku. Przy wyłączonej fladze jedzie zamiast tego jako etykieta milestone:<tytuł>. | include_milestones |
| Release | Story typu release. Opublikowany → accepted, szkic → unstarted. | include_releases |
| Zależność issue | Blocker na story. Tylko issues, nigdy pull requesty. | include_dependencies |
Typ story jest wywnioskowany, gdy issue go nie podaje. Etykieta zawierająca bug, fix lub defect — albo tytuł zaczynający się od fix czy bug — czyni z niego buga; chore, maintenance, devops lub infra czynią z niego chore; wszystko inne to feature. Warto to wiedzieć przed importem, bo w East Agile Tracker tylko features niosą punkty i tylko features karmią velocity. Zobacz Wprowadzenie → Stories.
7. Agent pracuje nad story
Dział zatytułowany „7. Agent pracuje nad story”Tablica ma już historię, a agent klucz. Pętla od tego miejsca to cztery wywołania.
Znajdź story albo napisz nowe. Przefiltruj tablicę w poszukiwaniu czegoś do podniesienia:
curl "https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories?state=unstarted" \ -H "X-TrackerToken: $TRACKER_TOKEN"import_source=github zawęża wynik do tego, co przyniósł import. Jeśli agent znalazł pracę, której repozytorium nigdy nie zapisało, tworzy story sam — zobacz Przewodnik API → Utwórz story.
Przejmij je. Agent dodaje się jako właściciel, wysyłając puste ciało:
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/owners \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{}'Puste ciało oznacza wywołującego, więc agent nie musi znać własnego id. Tablica pokazuje teraz agenta jako właściciela i po tym patrzący człowiek poznaje, że praca jest zajęta.
Rozpocznij je.
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/transitions \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"to": "started"}'Potem agent idzie i wykonuje pracę — czyta repozytorium, pisze kod, otwiera pull requesta. Ta część dzieje się w twoim narzędziu programistycznym, nie tutaj.
Podepnij pull requesta.
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/links \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"url": "https://github.com/octocat/hello-world/pull/42"}'URL pull requesta z GitHuba rozpoznaje się sam — nie musisz tego mówić. Story i kod, który je zamyka, są teraz o jedno kliknięcie od siebie, w obie strony.
Zakończ je. Przejdź na finished i tam się zatrzymaj. Feature ma przed sobą jeszcze delivered i accepted, a to są bramki przeglądu: ktoś inny niż agent decyduje, że praca jest w porządku. Chore takiej bramki nie ma — started → accepted to cała jego pozostała droga.
Tokeny i limity zapytań
Dział zatytułowany „Tokeny i limity zapytań”Każdy import się uwierzytelnia. Pobieranie issues, komentarzy i pull requestów idzie przez API GraphQL GitHuba, a GraphQL odrzuca żądanie bez tokenu — warstwy anonimowej nie ma, ani przy repozytorium publicznym, ani przy prywatnym. Pytanie nigdy nie brzmi, czy token trafi do GitHuba, tylko czyj.
Twój własny token
Dział zatytułowany „Twój własny token”Przekaż token w wywołaniu importu albo --token do GitHub-to-EAT. Wystarczy drobnoziarnisty osobisty token dostępu z prawem odczytu issues repozytorium. Prowadzi wywołania w górę do GitHuba i nic więcej: nigdy nie trafia do logów, nigdy do dziennika audytu, nigdy nie jest przechowywany ani zwracany w odpowiedzi czy w błędzie.
Do wszystkiego poza demem przynieś własny. Wydajesz wtedy budżet, którego nikt inny nie rusza, i żadna kontrola wstępna nie odrzuci cię z powodu cudzego importu.
--engine direct nie zostawia ci wyboru. Ten silnik czyta GitHuba z twojej maszyny, a nie przez Trackera, więc token serwera jest poza zasięgiem; uruchomienie bez tokenu kończy się kodem 2 i błędem użycia, zanim cokolwiek pobierze lub zapisze. GITHUB_TOKEN w twoim środowisku albo w .env liczy się tak samo jak --token.
Token wymusza przejście po issues, a nie cały silnik. direct czyta issues, komentarze i pull requesty przez GraphQL, który nie ma trybu anonimowego; REST-a dotyka wyłącznie dla listy releases i darmowej sondy /rate_limit. Narzędzie wciąż zawiera starszy anonimowy czytnik REST, który przeprowadzał import publicznego repozytorium w budżecie 60 na godzinę, ale żadna ścieżka CLI już do niego nie dociera i ma zostać usunięty — traktuj więc --token jako wymagany dla direct.
Współdzielony token wdrożenia
Dział zatytułowany „Współdzielony token wdrożenia”Nie wysyłaj żadnego token, a serwer podstawi token platformowy skonfigurowany przez operatora (GITHUB_IMPORT_PAT). Jadą z nim trzy ograniczenia:
- To konfiguracja opcjonalna. Hostowane eastagiletracker.com udostępnia taki token, więc import publicznego repozytorium bez tokenu tam działa. Instalacja własna — pobrany plik binarny — nie ma żadnego, dopóki jej operator nie ustawi
GITHUB_IMPORT_PATw środowisku, a do tego czasu odrzuca każdy import bez tokenu z400import_github_no_token. - Czyta wyłącznie repozytoria publiczne. Usługa hostowana wydaje go tylko do odczytu nad repozytoriami publicznymi, więc repozytorium prywatne zawsze wymaga twojego własnego tokenu.
- Wszyscy wywołujący we wdrożeniu dzielą jeden budżet. Zanim import bez tokenu ruszy, serwer odczytuje pozostałe punkty GraphQL współdzielonego tokenu i poniżej 500 odrzuca z
400import_github_shared_quota_low. Budżet, który skończy się w połowie importu, zabija zadanie zimport_github_rate_limited_platform. Oba komunikaty wskazują tę samą naprawę: podaj własny token.
Co daje token
Dział zatytułowany „Co daje token”GitHub mierzy swoje dwa API osobno, a pułap bez uwierzytelnienia leży o dwa rzędy wielkości niżej.
| API GitHuba | Służy do | Z tokenem | Bez tokenu |
|---|---|---|---|
| GraphQL | Issues, komentarze, pull requesty, pod-issues, zależności | 5000 punktów na godzinę, liczonych po węzłach, które zwraca zapytanie | Odrzucone — GraphQL nie ma warstwy anonimowej |
| REST | Releasy (include_releases) i kontrola wstępna /rate_limit | 5000 żądań na godzinę | 60 żądań na godzinę, liczonych na adres IP i dzielonych ze wszystkimi za nim |
Import nigdy nie spada na ten poziom 60 na godzinę: nie mając tokenu do wysłania, żądanie jest odrzucane z góry, zamiast ponawiane anonimowo. Ta liczba ma znaczenie dla tego, co robisz wokół importu — skrypt czytający GitHuba bezpośrednio albo powłoka w tej samej sieci co inni klienci wyczerpuje 60 żądań w sekundy.
Pozostały budżet odczytasz w każdej chwili; GET /rate_limit jest zwolniony z obu limitów, więc sprawdzenie nic nie kosztuje:
curl -H "Authorization: Bearer $GITHUB_TOKEN" https://api.github.com/rate_limitPunkty GraphQL to nie żądania. GitHub wycenia zapytanie po węzłach, które zwraca, więc jedna strona ze 100 issues wraz z komentarzami i przypisanymi osobami kosztuje wiele punktów, a duże repozytorium wydaje budżet godzinowy w znacznie mniejszej liczbie wywołań, niż sugerują liczby z epoki REST. --dry-run (krok 3) i dry_run (krok 4) kosztują każde tyle samo punktów co prawdziwe pobranie — to właśnie czyni ich liczby wiarygodnymi — więc przy dużym imporcie zaplanuj dwa przebiegi.
Dokąd dalej
Dział zatytułowany „Dokąd dalej”- Przewodnik API — gramatyka wyszukiwania, strumień zdarzeń, przejścia zbiorcze, zapisy idempotentne i reszta powierzchni.
- Instrukcja obsługi — te same operacje z interfejsu i pozostałych dziesięć importerów.
- Wprowadzenie — dlaczego maszyna stanów i cztery typy story mają właśnie taki kształt.
- GitHub-to-EAT — własne repozytorium importera: każda flaga, oba silniki i jak do niego dołożyć swoje.