Punta un agente a un repository GitHub e ottieni una board funzionante: ogni issue come storia, nello stato che la sua cronologia impone, con checklist, etichette e milestone portate dietro. Poi lo stesso agente prende una storia, se la assegna, la fa avanzare nella macchina a stati e collega la pull request che ha aperto.
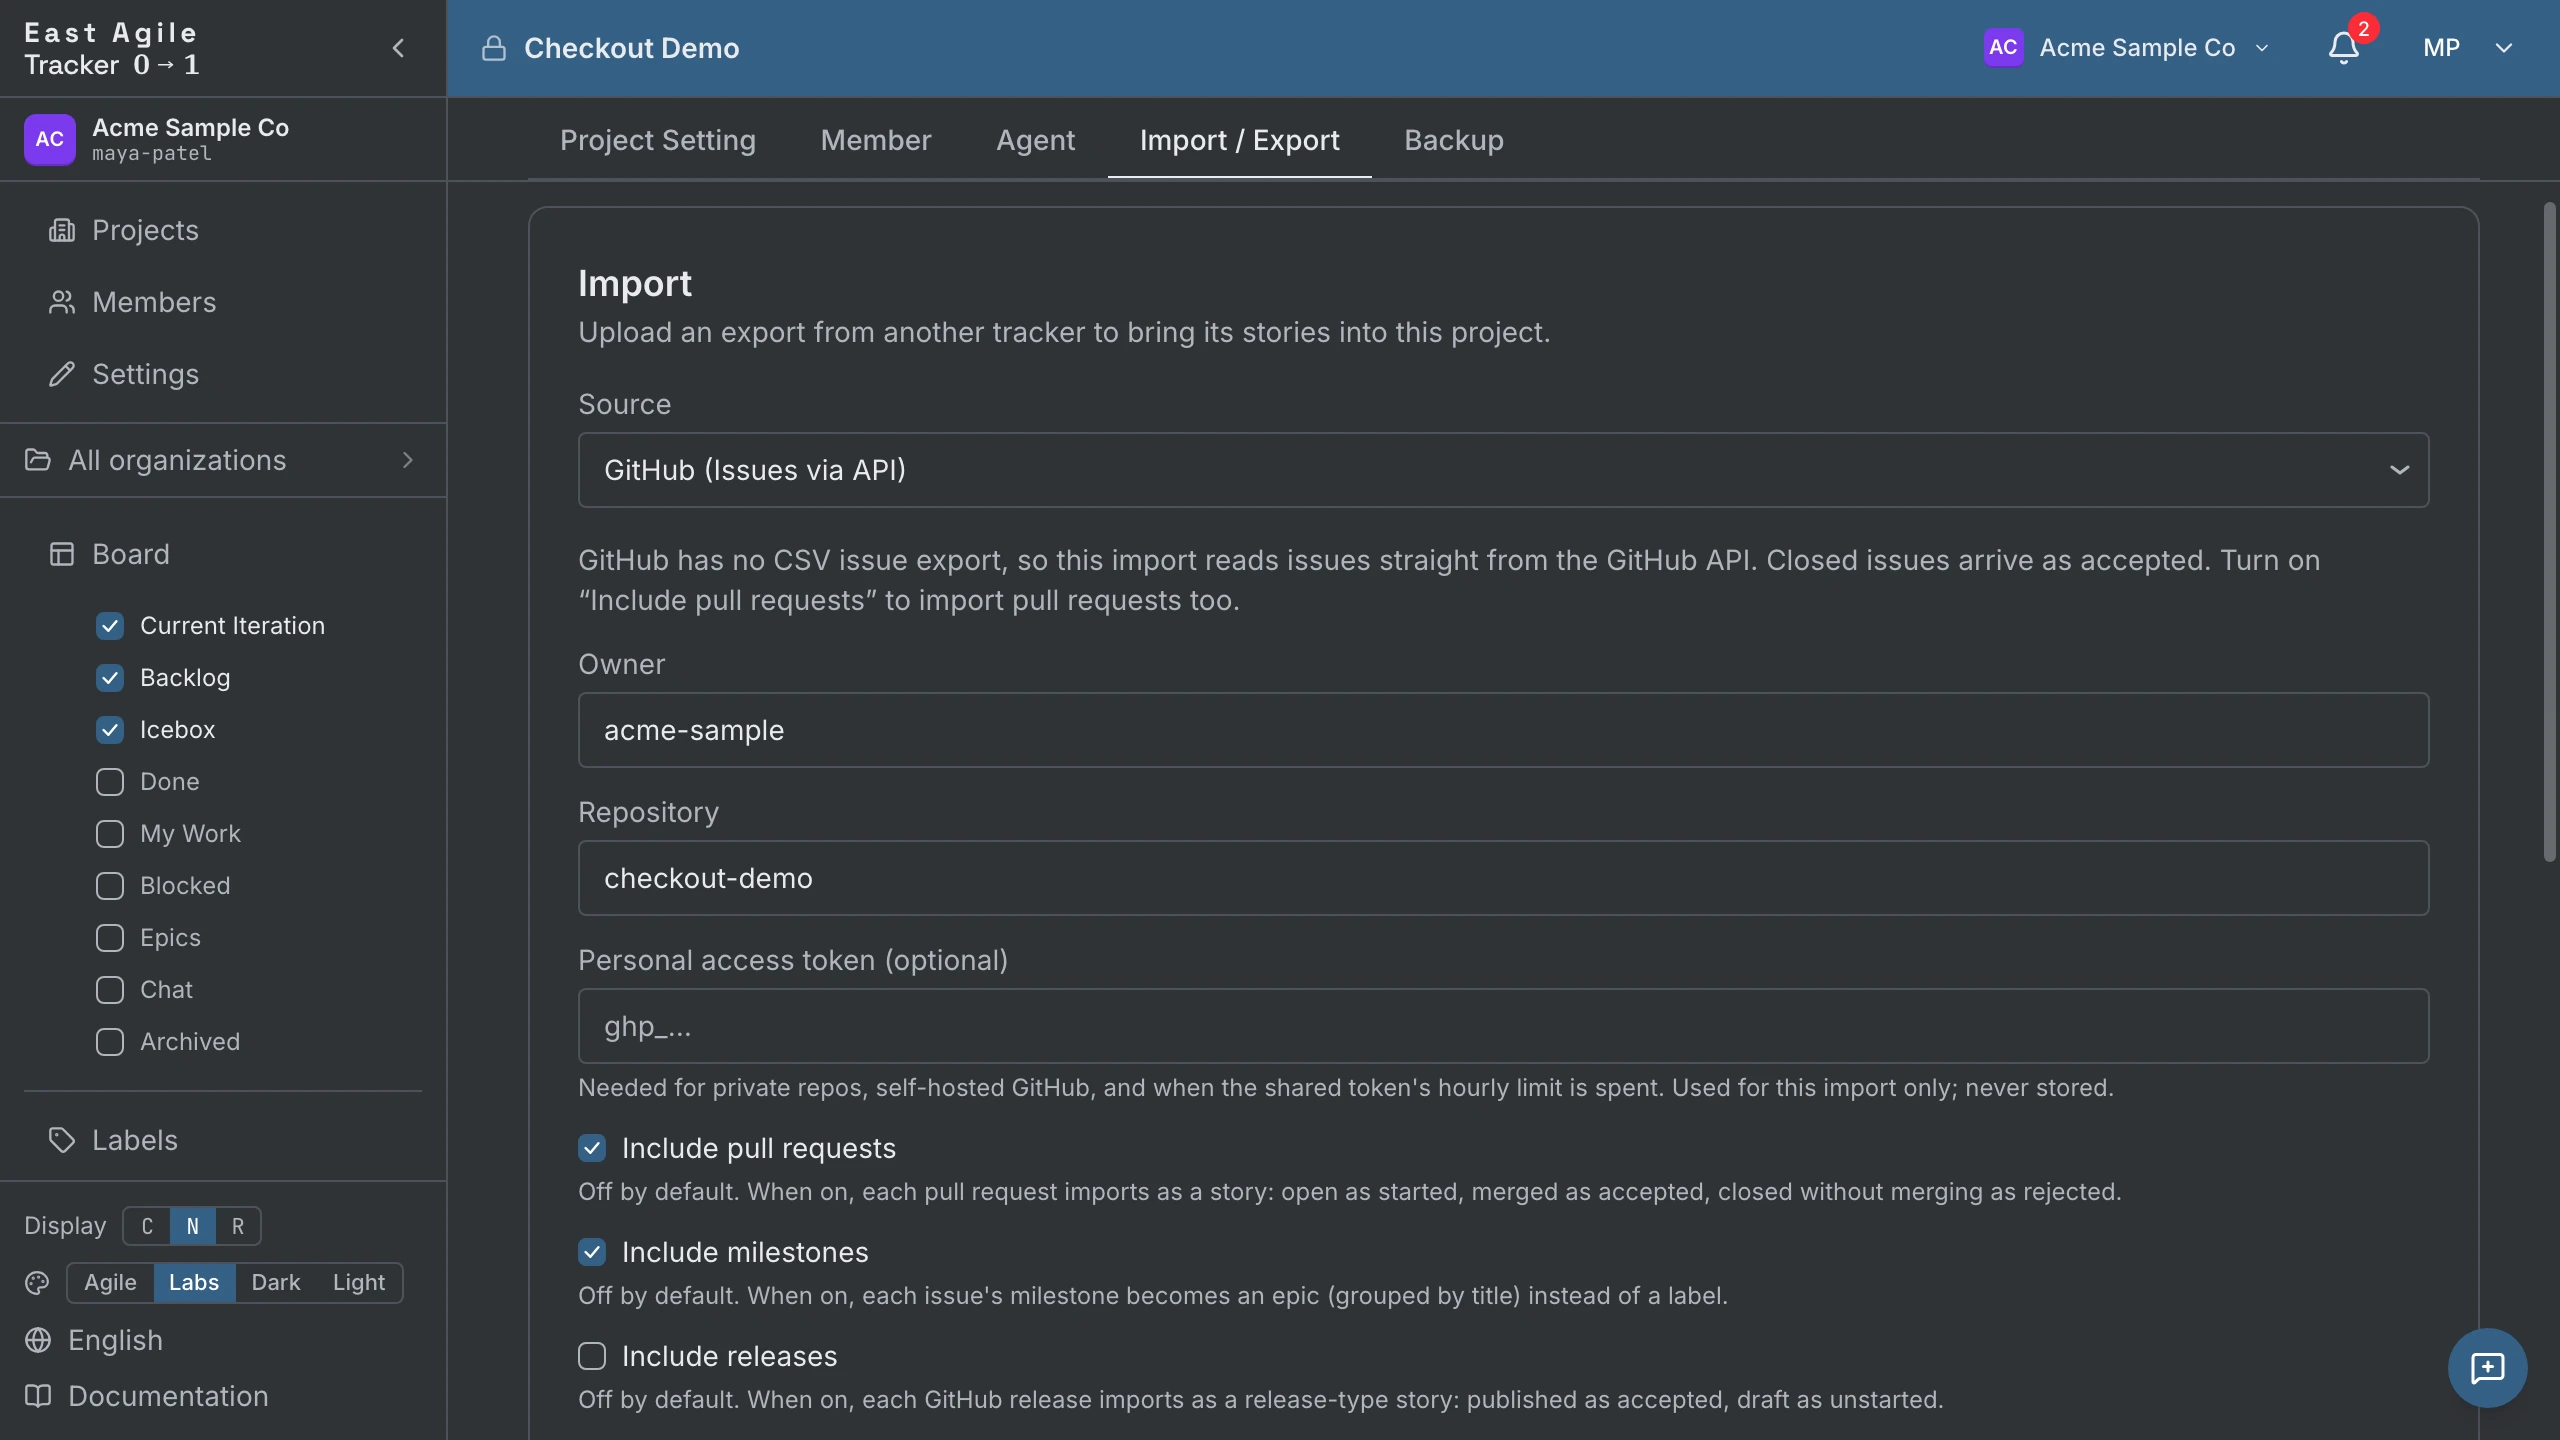
Questa pagina descrive quel ciclo da capo a fondo. Il passo di popolamento ha due strade: GitHub-to-EAT, l’importatore open source di East Agile, lo fa con un solo comando (passo 3); l’API di importazione fa lo stesso lavoro chiamata per chiamata (passi 4 e 5), ed è ciò che guida un agente quando vuole l’handle del job. Tutto il resto passa dall’API, perché il punto è che un agente possa fare il resto senza sorveglianza.
Non è un «import IA» separato. Il passo di popolamento è lo stesso importatore GitHub che puoi lanciare a mano da Impostazioni progetto → Importa / Esporta, descritto in Istruzioni operative → Importare da altri tracker. L’agente chiama lo stesso endpoint che chiameresti tu. Ciò che questa pagina aggiunge è tutto quello che c’è attorno: chi tiene la chiave, come controllare l’importazione prima che scriva, e cosa fa l’agente con la board una volta che esiste.
Cosa ti serve
Sezione intitolata “Cosa ti serve”- Un progetto — e una sessione o una chiave
ea_user_…con cui crearlo. - Una chiave agente — una chiave
ea_agent_…limitata a quel progetto. Il ruolo che le serve dipende da quanta parte del ciclo vuoi far svolgere all’agente; vedi il passo 2. Vedi anche Guida API → Due tipi di chiavi. - Un personal access token GitHub — con accesso in lettura alle issue del repository. Ogni importazione si autentica, perché il recupero passa dall’API GraphQL di GitHub e GraphQL rifiuta una richiesta senza token. Puoi ometterlo solo quando è il Tracker a recuperare per tuo conto: un repository pubblico, su un deployment che ha un token condiviso di riserva (il servizio ospitato eastagiletracker.com ne ha uno; un’installazione self-hosted non ne ha alcuno finché il suo operatore non imposta
GITHUB_IMPORT_PAT), e non con--engine directdi GitHub-to-EAT. Vedi Token e limiti di frequenza. - Node.js 22+ — solo per la strada GitHub-to-EAT del passo 3. La strada via API non richiede altro che
curl.
1. Creare il progetto
Sezione intitolata “1. Creare il progetto”Il progetto deve esistere prima della chiave agente, e deve crearlo una persona: le chiavi agente sono legate a un solo progetto al momento dell’emissione e non possono creare progetti. Crealo nell’interfaccia, o con la tua chiave ea_user_…:
curl -X POST https://eastagiletracker.com/api/v1/projects \ -H "X-TrackerToken: $TRACKER_USER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"name": "hello-world", "iteration_length_weeks": 1}'La risposta porta il project_id che serve a ogni chiamata qui sotto.
2. Emettere una chiave agente
Sezione intitolata “2. Emettere una chiave agente”Un proprietario del progetto crea le chiavi agente in Impostazioni progetto → Agenti. Il ruolo che scegli decide quanta parte di questa pagina l’agente può fare da solo, e ci sono due risposte sensate:
owner— una sola chiave esegue tutto il ciclo, importazione inclusa. Importare è riservato al proprietario, perché un’importazione riscrive in blocco la forma di un progetto. Emettere un agente con ruoloownerrichiede che tu stesso sia proprietario del progetto: il ruolo di un agente non può mai superare quello di chi lo ha creato.member— privilegio minimo. L’agente prende le storie, le muove, commenta e collega pull request, ma non può importare. L’importazione la esegui tu (passo 5) con la tua chiave, poi consegni la board all’agente.
In ogni caso, non lasciarla al valore predefinito. Una chiave agente nuova è viewer finché non dici altro, e un viewer può leggere la board ma non può prendere né muovere una storia — cioè quasi tutto questo ciclo.
Le chiavi agente contano qui per una ragione che va oltre l’accesso. Una chiave agente agisce come partecipante con un nome in un solo progetto, quindi ogni storia che crea, ogni cambio di stato che compie e ogni commento che scrive è attribuito a quell’agente nella cronologia — distinguibile dal tuo lavoro invece che confuso con esso.
export TRACKER_TOKEN="ea_agent_xxxxx"Fai leggere /meta all’agente prima di ogni altra cosa:
curl https://eastagiletracker.com/api/v1/meta \ -H "X-TrackerToken: $TRACKER_TOKEN"Questo risponde alle due domande che l’agente dovrebbe altrimenti indovinare: a quale progetto è legata la chiave (auth.project_id) e quali passaggi di stato sono leciti per ciascun tipo di storia (transitions). Una feature percorre unstarted → started → finished → delivered → accepted; una chore è solo unstarted → started → accepted. Leggere la mappa batte scriverla a mano nel codice.
3. Importare con GitHub-to-EAT
Sezione intitolata “3. Importare con GitHub-to-EAT”GitHub-to-EAT è l’importatore open source di East Agile: uno strumento a riga di comando con licenza MIT che compie l’intero passo di popolamento — i passi 4 e 5 qui sotto — con un solo comando. Usalo quando c’è una persona davanti a un terminale. Usa l’API sottostante quando è un agente a guidare senza sorveglianza e vuole l’handle del job da interrogare.
Richiede Node.js 22+ e non ha dipendenze a runtime proprie. Non è ancora pubblicato su npm, quindi installalo dal repository:
git clone git@github.com:EastAgile/GitHub-to-EAT.gitcd GitHub-to-EATnpm install --global .Poi puntalo alla chiave emessa al passo 2 e al progetto creato al passo 1:
export EAT_AGENT_KEY="ea_agent_xxxxx"github-to-eat --project $PROJECT_ID --repo octocat/hello-worldStampa prima una legenda della mappatura — esattamente come atterrerà ogni tipo selezionato — e chiede conferma prima di scrivere qualsiasi cosa. Fuori da un terminale, in una pipe, in CI o dentro un agente, non c’è dove mostrare quella richiesta, quindi un’esecuzione che scriverebbe deve passare --yes; senza, lo strumento esce con 2 e non scrive nulla invece di indovinare la tua risposta. Rilanciarlo è sicuro: ciò che è già stato importato viene saltato, mai duplicato.
| Flag | Cosa fa |
|---|---|
--dry-run | Controllo preliminare, poi stampa il piano che eseguirebbe — quante storie importerebbe, quante ne salterebbe perché già presenti — e non scrive nulla. Non richiede --yes. |
--include | Quali tipi importare, separati da virgole: issues,prs,milestones,releases,deps. Il valore predefinito è issues, e ogni selezione deve contenerlo. Sono gli stessi opt-in della tabella al passo 6. |
--token | Il tuo personal access token GitHub (valgono anche GITHUB_TOKEN nell’ambiente o in un .env). Gli serve repo, oppure il permesso granulare Issues: Read, su quel repository. Obbligatorio per un repository privato, per un server senza token condiviso di riserva e sempre per --engine direct. Omettilo sul motore predefinito del servizio ospitato e il Tracker spende il proprio budget condiviso — vedi Token e limiti di frequenza. |
--engine | server, il valore predefinito, invia una sola chiamata /import/json e lascia che sia il Tracker a recuperare, mappare e scrivere. direct esegue la stessa pipeline sulla tua macchina e scrive invece attraverso l’API pubblica — quindi legge GitHub da sé e richiede sempre un token, uscendo con 2 se manca. |
--states, --milestones, --story-type, --no-comments, --no-tasks | Restringono o sovrascrivono la mappatura per una singola esecuzione; nulla viene persistito. Ciascuno implica --engine direct. |
Imposta EAT_API_BASE e EAT_APP_BASE per puntarlo a un Tracker self-hosted o locale; entrambi puntano di default al servizio ospitato. Il README contiene il riferimento completo dei flag, i codici di uscita e la risoluzione dei problemi.
Tutto ciò che segue è quella stessa importazione guidata chiamata per chiamata, che è ciò che vuoi quando la esegue un agente.
4. Prima una prova a vuoto
Sezione intitolata “4. Prima una prova a vuoto”Importare è riservato al proprietario — usa una chiave agente con ruolo owner, o la tua chiave se hai lasciato l’agente a member. Eseguila prima con dry_run, prima di lasciarle scrivere alcunché:
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/import/json \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{ "source": "github", "owner": "octocat", "repo": "hello-world", "include_pull_requests": true, "include_milestones": true, "dry_run": true }'Una prova a vuoto recupera da GitHub, risolve e deduplica esattamente come quella vera, riporta gli stessi conteggi — imported, skipped, errors, unmatched — e poi annulla l’intera transazione. Nulla persiste e nessun evento di importazione completata raggiunge il tuo audit log. È il modo più economico di scoprire che volevi includere le milestone, o che un repo è più grande di quanto pensassi, mentre non ti costa ancora nulla.
Ogni chiamata a /import/json è asincrona, prova a vuoto inclusa: l’endpoint restituisce 202 con un handle del job, non un risultato, e i conteggi arrivano sul job quando lo interroghi (passo 5). Il job di una prova a vuoto raggiunge done come uno vero; la differenza è che nulla è stato scritto.
5. Eseguire l’importazione
Sezione intitolata “5. Eseguire l’importazione”Togli dry_run e invia di nuovo. Come prima, l’endpoint restituisce 202 con un handle del job:
{ "import_id": "…", "status": "pending" }Interroga il job finché non raggiunge uno stato terminale:
curl https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/imports/$IMPORT_ID \ -H "X-TrackerToken: $TRACKER_TOKEN"Lo stato percorre pending → fetching → writing → done | failed. Solo gli ultimi due sono terminali: done porta i conteggi del risultato, failed porta un messaggio di errore e un codice macchina stabile su cui ramificare. Mentre il recupero pagina, progress_current e progress_total dicono a che pagina è arrivato — vale la pena mostrarlo se c’è una persona che guarda.
Token. Passa "token": "github_pat_…". Omettilo e il server sostituisce il token di piattaforma condiviso, che legge solo repository pubblici ed è conteggiato su ogni chiamante del deployment — Token e limiti di frequenza spiega quanto ti costa. Qualunque token venga usato, guida le chiamate a GitHub e nient’altro: non viene mai registrato nei log, mai nell’audit log, mai memorizzato e mai restituito in una risposta o in un errore.
Rilanciare è sicuro. Una riga già importata viene riconosciuta dal suo id di origine e saltata, non duplicata. Una seconda importazione completa la board con quanto è comparso dopo la prima.
6. Cosa atterra sulla board
Sezione intitolata “6. Cosa atterra sulla board”Le issue si importano per impostazione predefinita. Tutto il resto è opt-in, un flag per tipo:
| Da GitHub | Diventa | Flag |
|---|---|---|
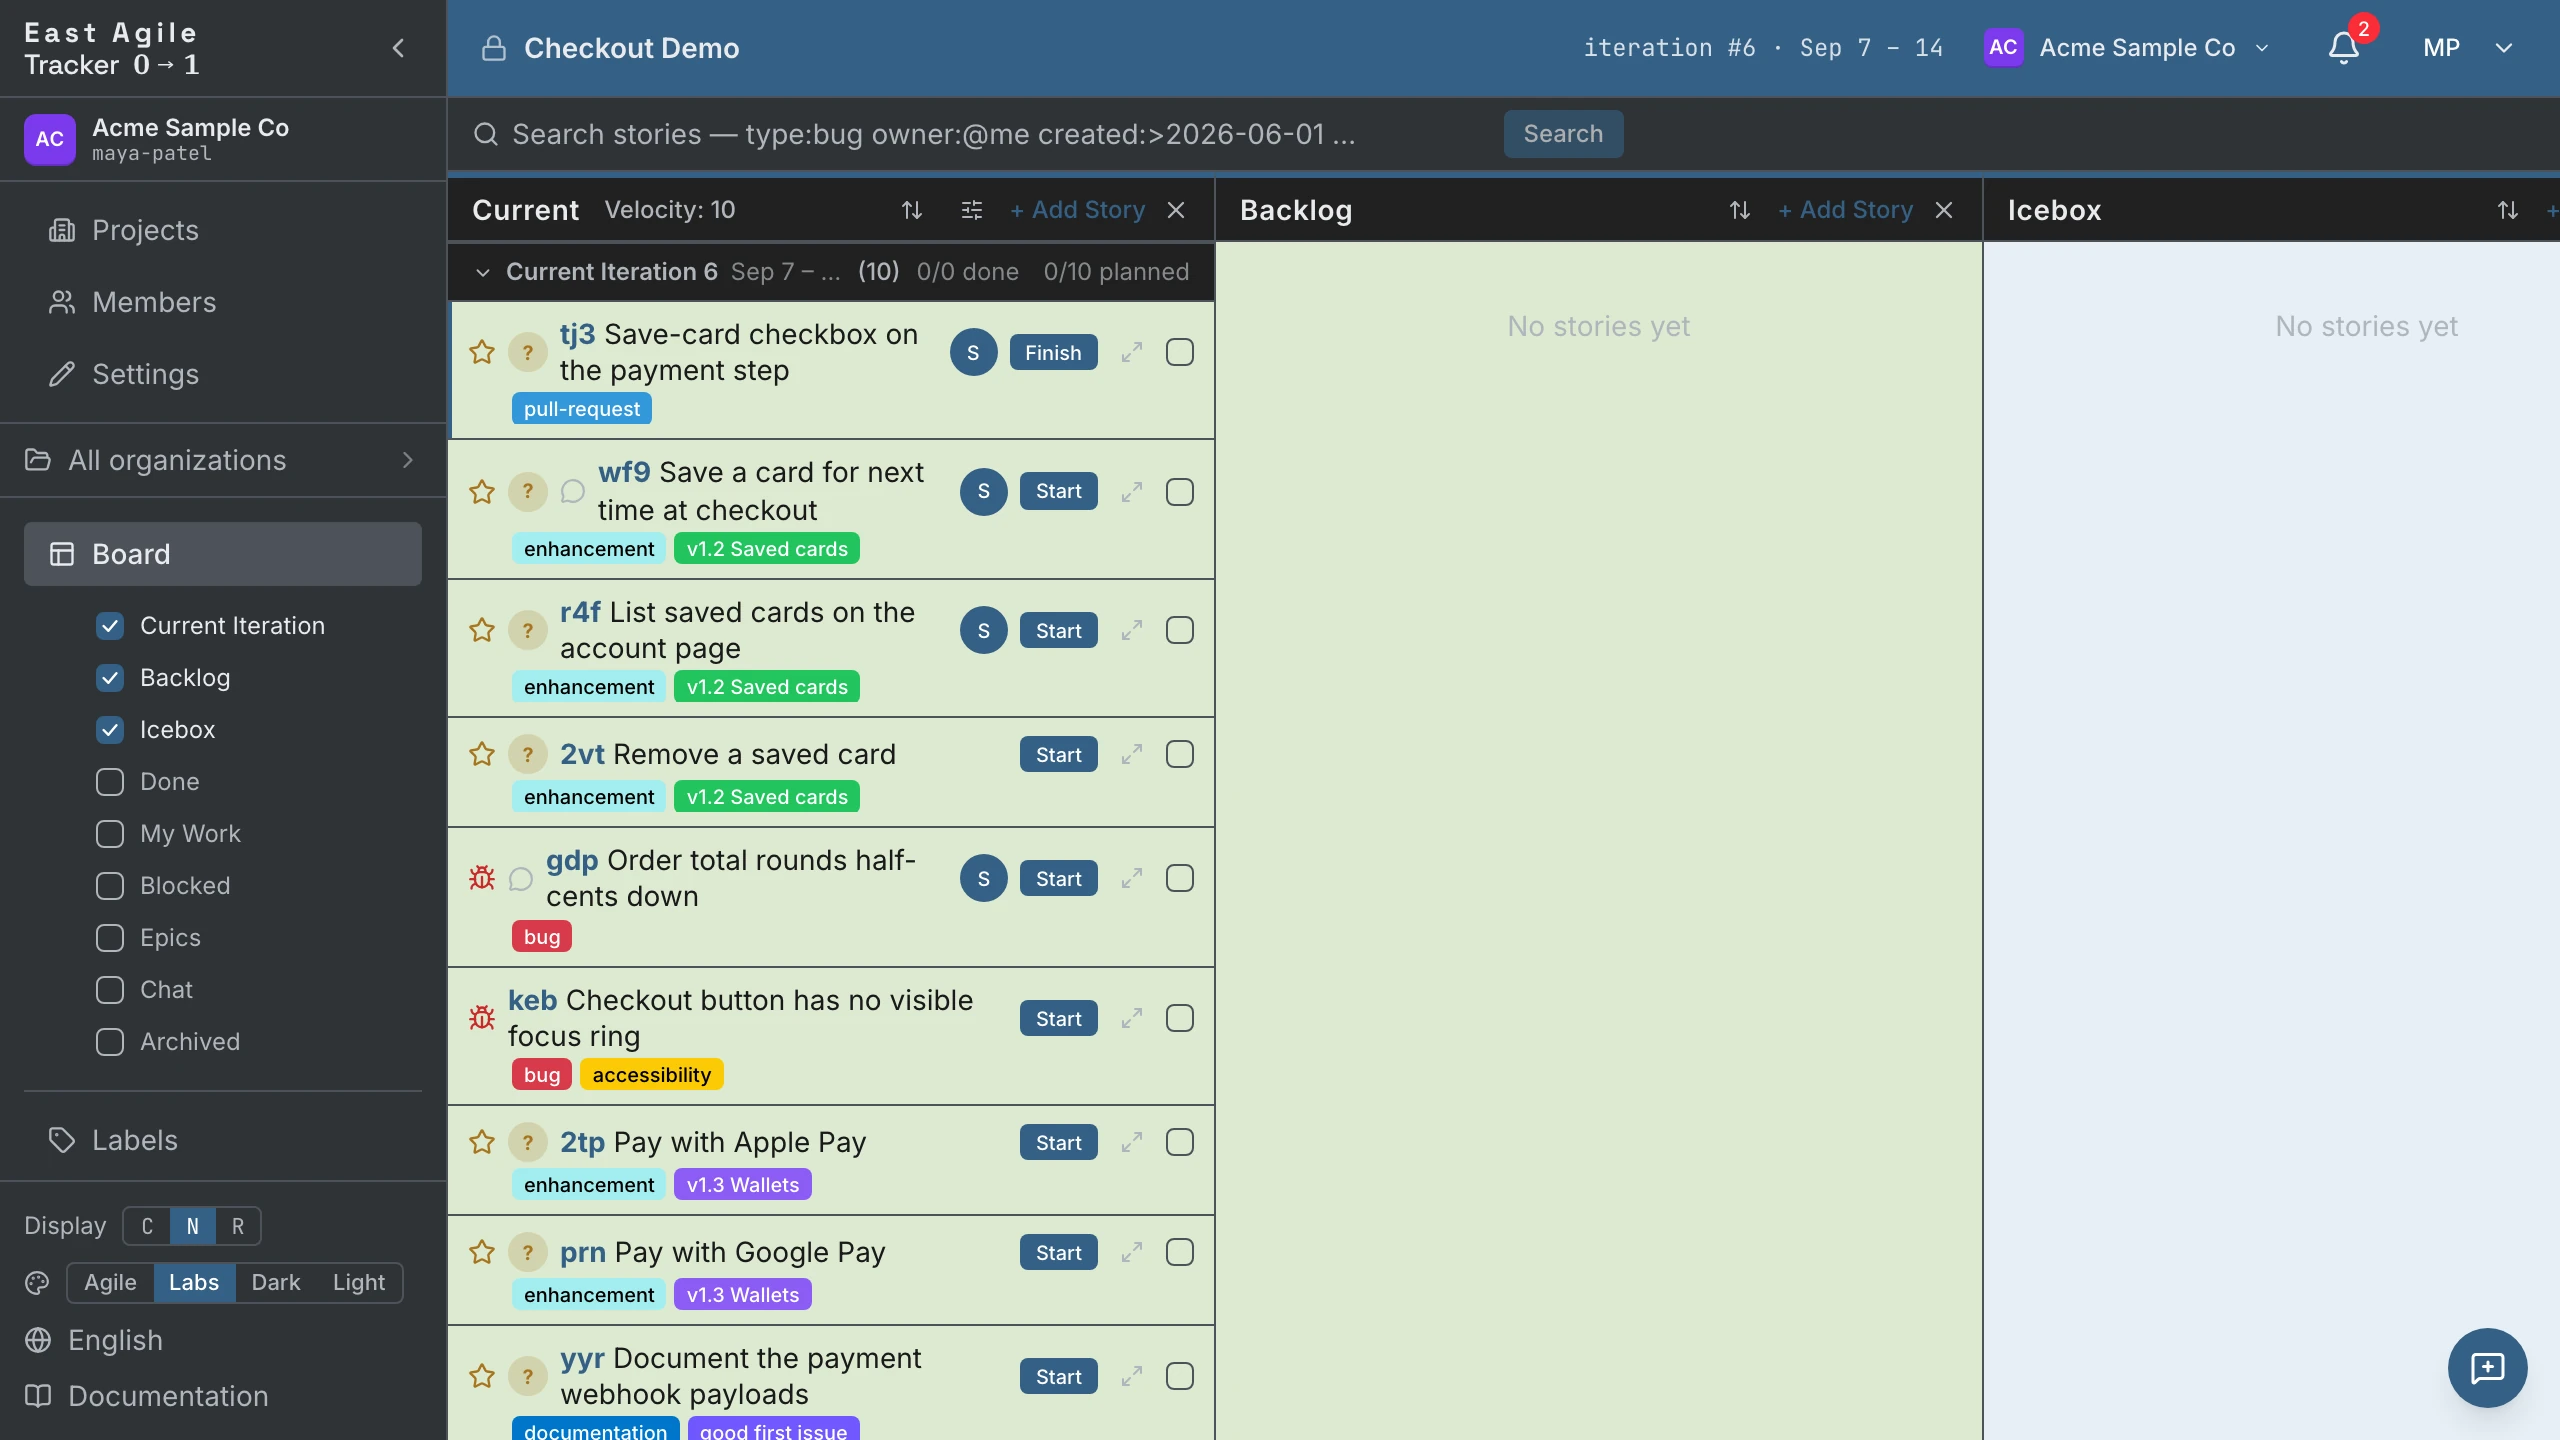
| Issue | Una storia. Aperta → unstarted nel Backlog. Chiusa → accepted, oppure rejected quando GitHub dice che la issue è stata chiusa come not_planned o duplicate (la storia porta allora un’etichetta corrispondente). | predefinito |
| Checklist nel corpo della issue | Task — ogni riga - [ ] / - [x] diventa un task nell’ordine del corpo, e [x] arriva già completato. La checklist resta anche nella descrizione. | predefinito |
| Etichette | Etichette, riportate così come sono. | predefinito |
| Pull request | Una storia etichettata pull-request. Aperta → started, unita → accepted, chiusa senza merge → rejected. | include_pull_requests |
| Milestone | Un epic, intitolato come la milestone e deduplicato per titolo — due issue che condividono una milestone finiscono in un solo epic. Con il flag spento viaggia invece come etichetta milestone:<titolo>. | include_milestones |
| Release | Una storia di release. Pubblicata → accepted, bozza → unstarted. | include_releases |
| Dipendenza fra issue | Un blocker sulla storia. Solo issue, mai pull request. | include_dependencies |
Il tipo di storia viene dedotto quando la issue non lo dice. Un’etichetta che contiene bug, fix o defect — o un titolo che inizia con fix o bug — ne fa un bug; chore, maintenance, devops o infra ne fanno una chore; tutto il resto è una feature. Vale la pena saperlo prima di importare, perché in East Agile Tracker solo le feature portano punti e solo le feature alimentano la velocity. Vedi Introduzione → Storie.
7. L’agente lavora una storia
Sezione intitolata “7. L’agente lavora una storia”Ora la board ha una cronologia e l’agente ha una chiave. Da qui in poi il ciclo sono quattro chiamate.
Trovare una storia, o scriverne una. Filtra la board cercando qualcosa da prendere:
curl "https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories?state=unstarted" \ -H "X-TrackerToken: $TRACKER_TOKEN"import_source=github restringe a ciò che l’importazione ha portato. Se l’agente ha trovato lavoro che il repo non ha mai registrato, crea invece la storia — vedi Guida API → Creare una storia.
Prenderla. Un agente si aggiunge come proprietario inviando un corpo vuoto:
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/owners \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{}'Un corpo vuoto significa il chiamante, quindi l’agente non deve conoscere il proprio id. La board mostra ora l’agente come proprietario, ed è così che una persona che guarda sa che il lavoro è preso.
Avviarla.
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/transitions \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"to": "started"}'Poi l’agente va a fare il lavoro — legge il repo, scrive il codice, apre la pull request. Quella parte avviene nel tuo strumento di sviluppo, non qui.
Allegare la pull request.
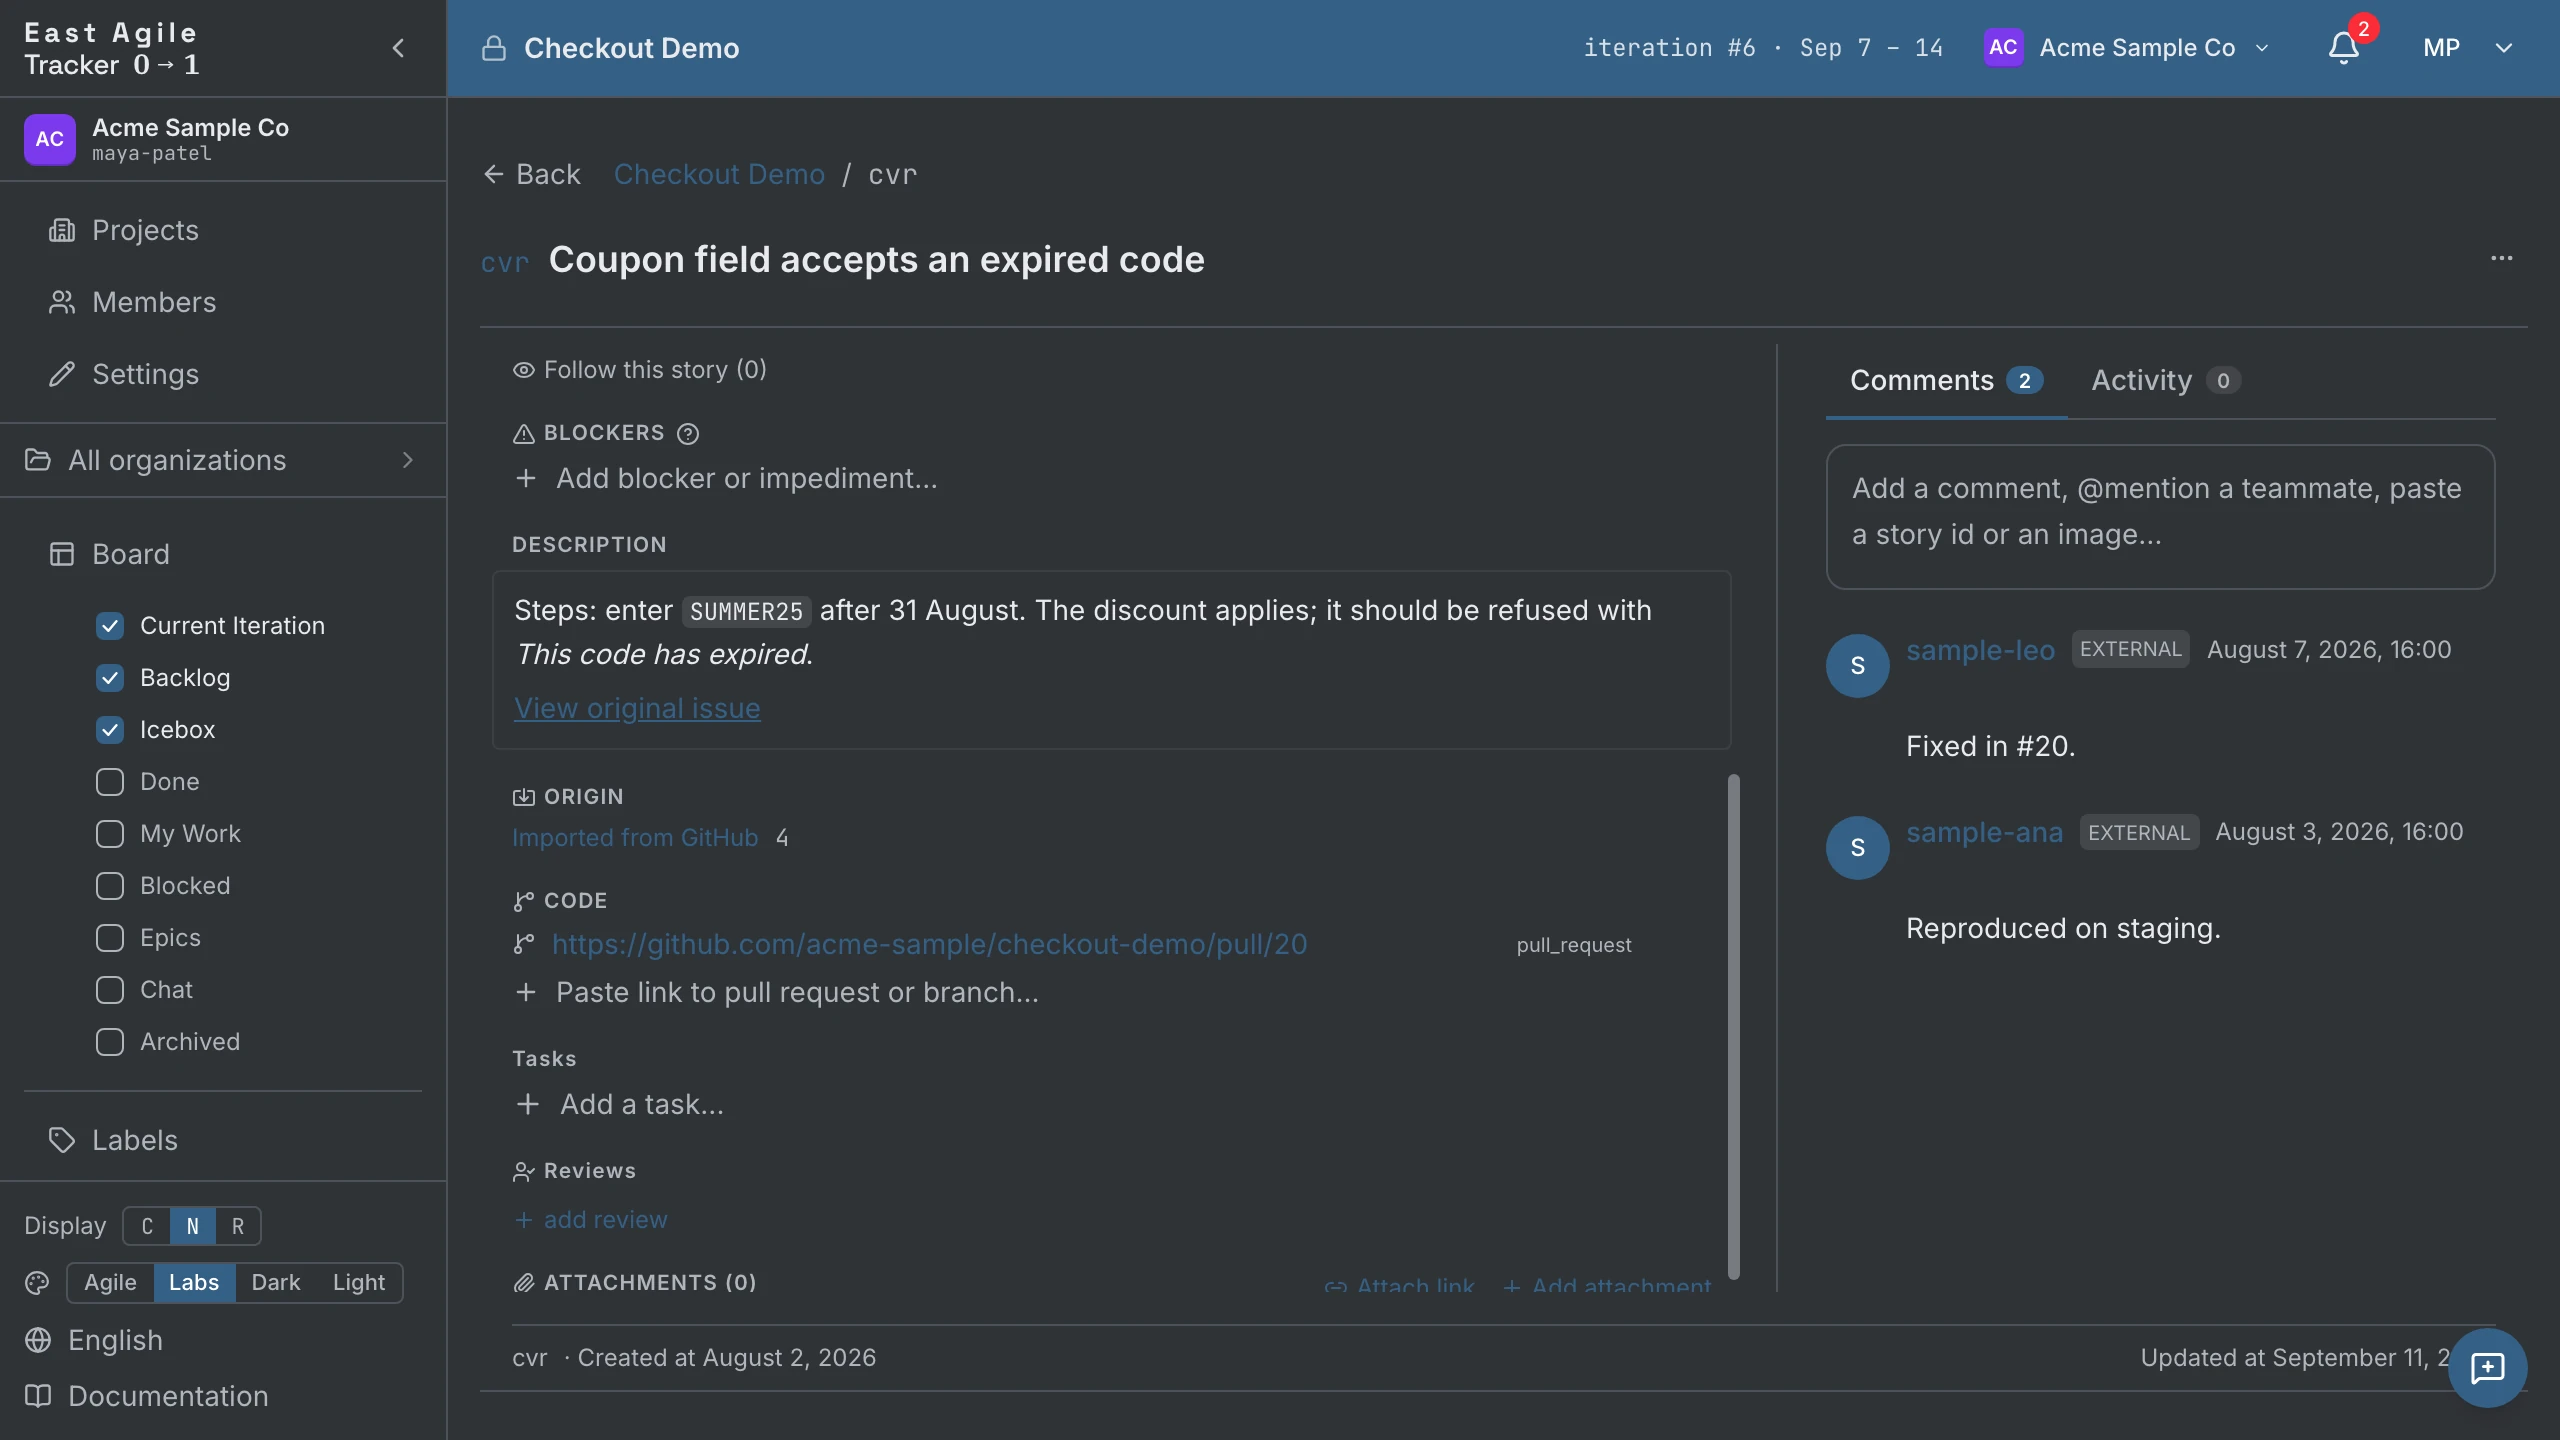
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/links \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"url": "https://github.com/octocat/hello-world/pull/42"}'Un URL di pull request GitHub viene riconosciuto come tale — non devi dirlo. La storia e il codice che la chiude sono ora a un clic l’una dall’altro, in entrambe le direzioni.
Chiuderla. Passa a finished e fermati lì. Una feature ha ancora davanti delivered e accepted, e quelli sono i controlli di revisione: qualcuno diverso dall’agente decide che il lavoro è giusto. Una chore non ha quel controllo — started → accepted è tutto il suo percorso residuo.
Token e limiti di frequenza
Sezione intitolata “Token e limiti di frequenza”Ogni importazione si autentica. Il recupero di issue, commenti e pull request passa dall’API GraphQL di GitHub, e GraphQL rifiuta una richiesta senza token — non esiste un livello anonimo, né su un repository pubblico né su uno privato. La domanda non è mai se un token arriva a GitHub, ma solo di chi.
Il tuo token
Sezione intitolata “Il tuo token”Passa token nella chiamata di importazione, oppure --token a GitHub-to-EAT. Basta un personal access token granulare con accesso in lettura alle issue del repository. Guida le chiamate a GitHub e nient’altro: non viene mai registrato nei log, mai nell’audit log, mai memorizzato e mai restituito in una risposta o in un errore.
Porta il tuo per qualsiasi cosa oltre una demo. Così spendi un budget che nessun altro tocca, e nessun controllo preliminare può rifiutarti per l’importazione di qualcun altro.
--engine direct non ti lascia scelta. Quel motore legge GitHub dalla tua macchina invece che attraverso il Tracker, quindi il token del server è fuori portata; un’esecuzione senza token esce con 2 e un errore d’uso prima di recuperare o scrivere alcunché. GITHUB_TOKEN nel tuo ambiente o nel tuo .env vale quanto --token.
A imporre il token è il percorso delle issue, non l’intero motore. direct legge issue, commenti e pull request su GraphQL, che non ha una modalità anonima; tocca REST solo per l’elenco delle release e per la sonda gratuita /rate_limit. Lo strumento include ancora un vecchio lettore REST anonimo che portava a termine l’importazione di un repository pubblico entro il budget di 60 all’ora, ma nessun percorso della CLI lo raggiunge più ed è destinato alla cancellazione: considera quindi --token obbligatorio per direct.
Il token condiviso del deployment
Sezione intitolata “Il token condiviso del deployment”Non inviare alcun token e il server sostituisce il token di piattaforma che il suo operatore ha configurato (GITHUB_IMPORT_PAT). Portano con sé tre limiti:
- È configurazione facoltativa. Il servizio ospitato eastagiletracker.com ne fornisce uno, quindi lì un’importazione di repository pubblico senza token funziona. Un’installazione self-hosted — il binario scaricato — non ne ha alcuno finché il suo operatore non imposta
GITHUB_IMPORT_PATnell’ambiente, e fino ad allora rifiuta ogni importazione senza token con400import_github_no_token. - Legge solo repository pubblici. Il servizio ospitato lo emette in sola lettura sui repo pubblici, quindi un repository privato richiede sempre il tuo token.
- Ogni chiamante del deployment condivide un unico budget. Prima che parta un’importazione senza token, il server legge i punti GraphQL rimasti al token condiviso e la rifiuta con
400import_github_shared_quota_lowsotto i 500. Un budget che si esaurisce a metà importazione fa fallire il job conimport_github_rate_limited_platform. Entrambi i messaggi indicano lo stesso rimedio: fornire il proprio token.
Cosa ti dà il token
Sezione intitolata “Cosa ti dà il token”GitHub misura le sue due API separatamente, e il tetto non autenticato è due ordini di grandezza più basso.
| API GitHub | Serve per | Con un token | Senza |
|---|---|---|---|
| GraphQL | Issue, commenti, pull request, sotto-issue, dipendenze | 5.000 punti all’ora, calcolati sui nodi che una query restituisce | Rifiutato — GraphQL non ha un livello anonimo |
| REST | Release (include_releases) e il controllo preliminare /rate_limit | 5.000 richieste all’ora | 60 richieste all’ora, contate per indirizzo IP e condivise con chiunque stia dietro di esso |
Un’importazione non ricade mai su quel livello da 60 all’ora: senza un token da inviare, la richiesta viene rifiutata in partenza invece di essere ritentata in anonimo. Il numero conta per ciò che fai attorno all’importazione — uno script che legge GitHub direttamente, o una shell nella stessa rete di altri client, esaurisce 60 richieste in pochi secondi.
Leggi il tuo budget residuo quando vuoi; GET /rate_limit è esente da entrambi i limiti, quindi il controllo non costa nulla:
curl -H "Authorization: Bearer $GITHUB_TOKEN" https://api.github.com/rate_limitI punti GraphQL non sono richieste. GitHub calcola il costo di una query sui nodi che restituisce, quindi una pagina di 100 issue con i loro commenti e assegnatari costa molti punti, e un repository grande spende il budget orario in molte meno chiamate di quanto suggeriscano i numeri dell’era REST. --dry-run (passo 3) e dry_run (passo 4) costano ciascuno gli stessi punti del recupero vero — è questo che rende affidabili i loro conteggi — quindi metti in conto due passate quando prepari un’importazione grande.
Dove andare adesso
Sezione intitolata “Dove andare adesso”- Guida API — la grammatica di ricerca, il flusso di eventi, le transizioni in blocco, le scritture idempotenti e il resto della superficie.
- Istruzioni operative — le stesse operazioni dall’interfaccia, e gli altri dieci importatori.
- Introduzione — perché la macchina a stati e i quattro tipi di storia hanno questa forma.
- GitHub-to-EAT — il repository dell’importatore: ogni flag, entrambi i motori, e come contribuire.