把一个智能体指向某个 GitHub 仓库,你就能拿回一块可以开工的看板:每个 issue 都成为一条故事,处于其历史所决定的状态,连同清单、标签和里程碑一起带过来。随后同一个智能体拿起一条故事,认领它,推着它走过状态机,并链接上它开的拉取请求。
本页把这条闭环从头讲到尾。填充这一步有两条路:GitHub-to-EAT——East Agile 的开源导入工具——一条命令就能搞定(步骤 3);导入 API 则一次调用一次调用地做同样的事(步骤 4 和 5),这正是智能体想要作业句柄时所驱动的。此后的一切都跑在 API 上,因为重点就在于智能体能无人值守地完成余下的工作。
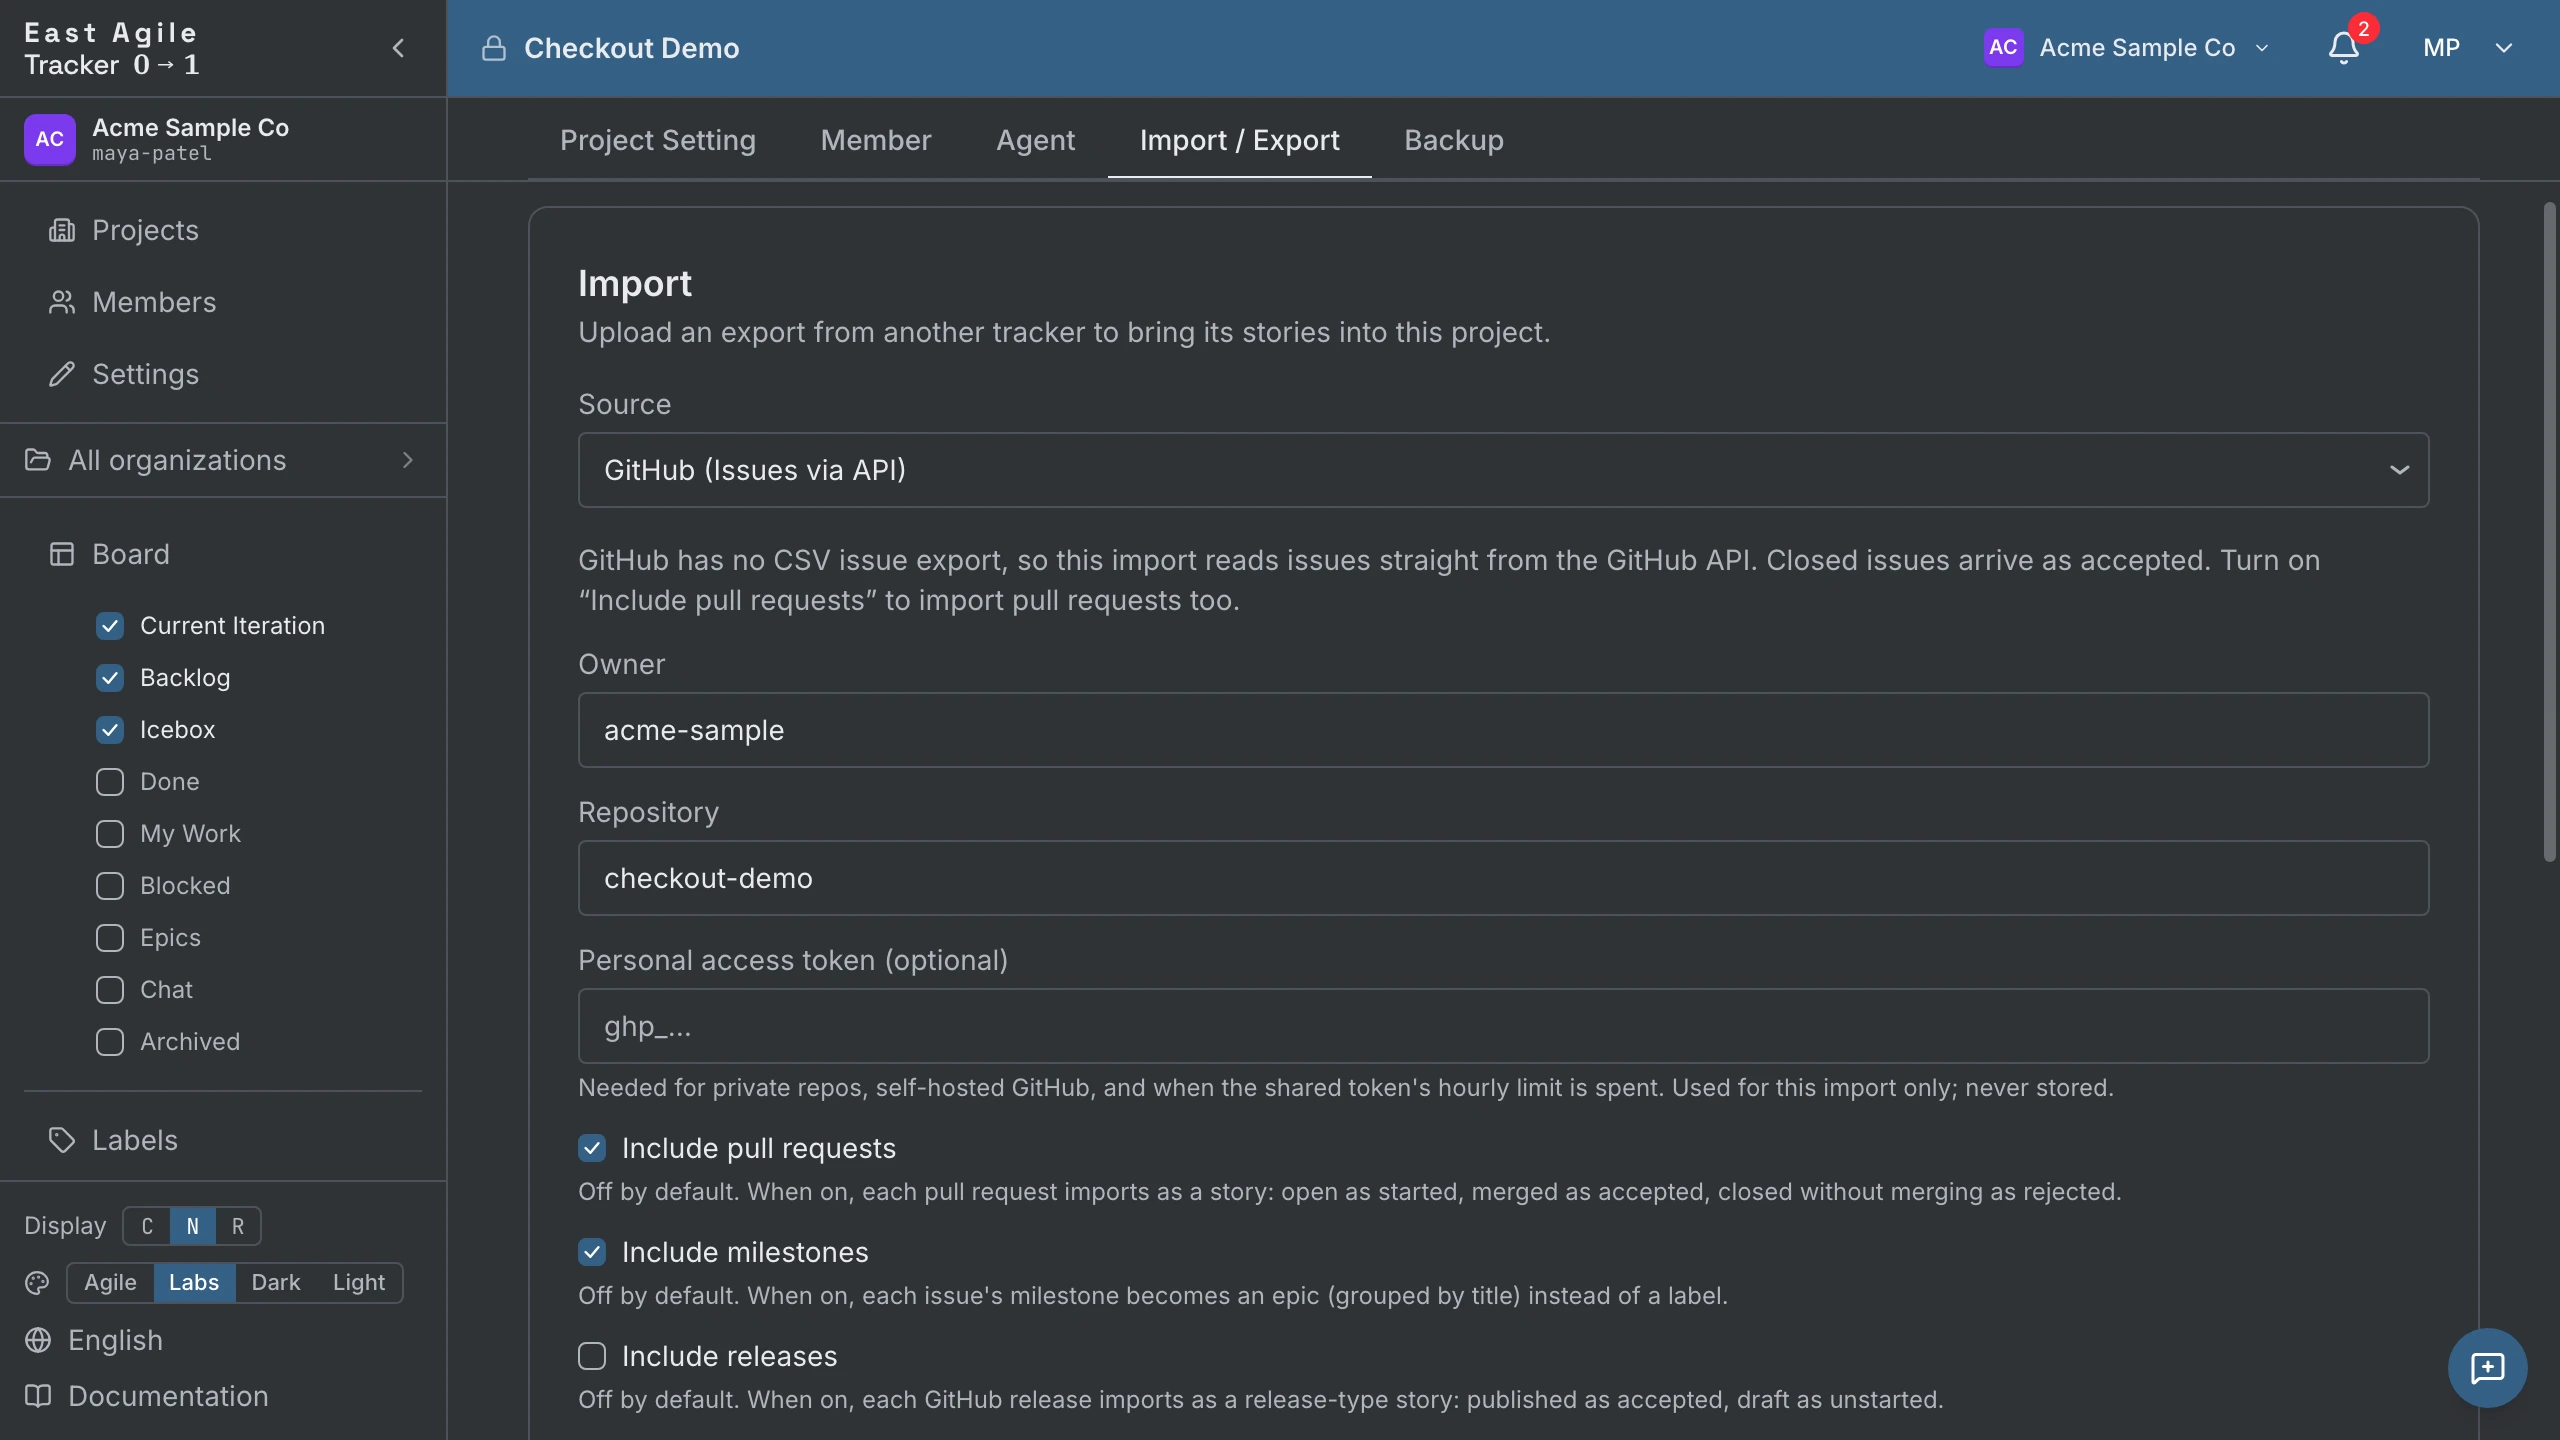
这不是另一套「AI 导入」。 填充这一步用的就是你能从 项目设置 → 导入 / 导出 手动运行的那个 GitHub 导入器,详见操作说明 → 从其他跟踪工具导入。智能体调用的正是你会调用的同一个端点。本页补上的是它周围的一切:谁持有密钥、在写入之前如何核对导入、以及看板建好之后智能体拿它做什么。
- 一个项目 —— 以及用来创建它的会话或
ea_user_…密钥。 - 一把智能体密钥 —— 一把限定在该项目上的
ea_agent_…密钥。它需要什么角色,取决于你想让智能体跑完闭环的多少;见步骤 2。另见API 指南 → 两种密钥。 - 一个 GitHub 个人访问令牌 —— 具备该仓库 issue 的读取权限。每一次导入都会认证,因为抓取跑在 GitHub 的 GraphQL API 上,而 GraphQL 会拒绝不带令牌的请求。只有当 Tracker 代你抓取时才可以省略它:公开仓库,且部署本身持有共享回退令牌(托管的 eastagiletracker.com 有一个;自托管安装在运维方设置
GITHUB_IMPORT_PAT之前没有),并且不是 GitHub-to-EAT 的--engine direct。参见令牌与速率限制。 - Node.js 22+ —— 只有步骤 3 的 GitHub-to-EAT 这条路需要。API 那条路除了
curl什么都不需要。
1. 创建项目
Section titled “1. 创建项目”项目必须先于智能体密钥存在,而且必须由人来创建:智能体密钥在铸造时就绑定到一个项目,无法引导出新项目。在界面里创建,或者用你自己的 ea_user_… 密钥:
curl -X POST https://eastagiletracker.com/api/v1/projects \ -H "X-TrackerToken: $TRACKER_USER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"name": "hello-world", "iteration_length_weeks": 1}'响应里带着下面每个调用都需要的 project_id。
2. 铸造一把智能体密钥
Section titled “2. 铸造一把智能体密钥”项目所有者在 项目设置 → 智能体 中创建智能体密钥。你挑的角色决定了本页有多少是智能体能独立完成的,而合理的答案有两个:
owner—— 一把密钥跑完整条闭环,导入也包含在内。导入仅限所有者,因为一次导入会整体改写项目的形态。铸造owner角色的智能体要求你本人就是项目所有者:智能体的角色永远不会超过创建者的角色。member—— 最小权限。智能体认领故事、移动故事、评论并链接拉取请求,但不能导入。导入由你自己用自己的密钥执行(步骤 5),随后把看板交给智能体。
无论选哪种,都别停在默认值上。新的智能体密钥在你不另行指定时是 viewer,而 viewer 能读看板却不能认领或移动故事——那恰恰是这条闭环的大部分。
智能体密钥在这里重要,还有一个超出访问权限的理由。一把智能体密钥表现为单个项目中的具名参与者,因此它创建的每条故事、它做的每次状态变更、它写的每条评论,在历史里都归属于那个智能体——可以和你自己的工作区分开来,而不是混作一团。
export TRACKER_TOKEN="ea_agent_xxxxx"先让智能体读 /meta,其他一切都排在后面:
curl https://eastagiletracker.com/api/v1/meta \ -H "X-TrackerToken: $TRACKER_TOKEN"这回答了智能体否则只能猜的两个问题:密钥绑定在哪个项目上(auth.project_id),以及每种故事类型允许哪些状态流转(transitions)。feature 走 unstarted → started → finished → delivered → accepted;chore 只有 unstarted → started → accepted。读这张图胜过把它写死在代码里。
3. 用 GitHub-to-EAT 导入
Section titled “3. 用 GitHub-to-EAT 导入”GitHub-to-EAT 是 East Agile 自己的开源导入工具:一个 MIT 许可的命令行程序,一条命令就完成整个填充步骤——下面的步骤 4 和 5。当有人坐在终端前时,就用它。当智能体无人值守地驱动、并且想要一个作业句柄来轮询时,就用它底下的 API。
它需要 Node.js 22+,自身没有运行时依赖。它尚未发布到 npm,所以从仓库安装:
git clone git@github.com:EastAgile/GitHub-to-EAT.gitcd GitHub-to-EATnpm install --global .然后把它指向步骤 2 铸造的密钥和步骤 1 创建的项目:
export EAT_AGENT_KEY="ea_agent_xxxxx"github-to-eat --project $PROJECT_ID --repo octocat/hello-world它会先打印一份映射图例——每种被选中的类型究竟会落成什么样——并在写入任何东西之前请你确认。脱离终端后,在管道里、在 CI 里或在智能体里,都没有地方展示那个提示,所以一次会写入的运行必须传 --yes;不传的话,工具会以 2 退出且不写入任何东西,而不是替你猜答案。重跑是安全的:已经导入过的会被跳过,绝不重复。
| 开关 | 作用 |
|---|---|
--dry-run | 先做预检,然后打印它将要执行的计划——会导入多少条故事、会因为已存在而跳过多少条——并且什么都不写。不需要 --yes。 |
--include | 要导入哪些类型,以逗号分隔:issues,prs,milestones,releases,deps。默认为 issues,且任何选择都必须包含它。这与步骤 6 表格里的选项相同。 |
--token | 你的 GitHub 个人访问令牌(环境变量或 .env 中的 GITHUB_TOKEN 同样算数)。它在该仓库上需要 repo,或者细粒度的 Issues: Read。私有 仓库必需,没有共享回退令牌的服务器必需,--engine direct 则始终必需。在托管服务的默认引擎上省略它,Tracker 就会花掉自己的共享额度——参见令牌与速率限制。 |
--engine | 默认的 server 发出一次 /import/json 调用,让 Tracker 去抓取、映射和写入。direct 在你自己的机器上跑同一条流水线,改为通过公开 API 写入——也就是说它自己去读 GitHub,因此始终需要令牌,没有就以 2 退出。 |
--states、--milestones、--story-type、--no-comments、--no-tasks | 为单次运行收窄或覆盖映射;什么都不会持久化。它们各自都隐含 --engine direct。 |
设置 EAT_API_BASE 和 EAT_APP_BASE 可把它指向自托管或本地的 Tracker;两者默认都指向托管服务。README 里有完整的开关参考、退出码和排障说明。
下面的一切都是同一次导入,只是改为一次调用一次调用地驱动——当由智能体来跑时,你要的正是这种形态。
4. 先空跑一次
Section titled “4. 先空跑一次”导入仅限所有者——用 owner 角色的智能体密钥,或者,如果你把智能体留在 member,就用你自己的密钥。在让它写入任何东西之前,先带 dry_run 跑一次:
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/import/json \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{ "source": "github", "owner": "octocat", "repo": "hello-world", "include_pull_requests": true, "include_milestones": true, "dry_run": true }'一次空跑会从 GitHub 抓取、解析映射并去重,与真实运行完全一致,报告同样的计数——imported、skipped、errors、unmatched——然后把整个事务回滚。什么都不会留下,也没有任何「导入完成」事件进入你的审计日志。它是最便宜的办法,让你在还没付出任何代价时就发现:你本来想把里程碑也带上,或者这个仓库比你以为的大。
对 /import/json 的每一次调用都是异步的,空跑也不例外:端点返回 202 和一个作业句柄,而不是结果,计数会在你轮询作业时(步骤 5)随作业送达。空跑的作业会像真实导入一样到达 done;区别只在于什么都没有写入。
5. 执行导入
Section titled “5. 执行导入”去掉 dry_run 再发一次。和之前一样,端点返回 202 和一个作业句柄:
{ "import_id": "…", "status": "pending" }轮询作业,直到它到达终态:
curl https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/imports/$IMPORT_ID \ -H "X-TrackerToken: $TRACKER_TOKEN"状态依次为 pending → fetching → writing → done | failed。只有最后两个是终态:done 带着结果计数,failed 带着错误消息和一个可用于分支判断的稳定机器码。抓取分页期间,progress_current 和 progress_total 告诉你它走到第几页——如果有人在旁边看,值得显示出来。
令牌。 传 "token": "github_pat_…"。省略它,服务器就换上共享的平台令牌,该令牌只读公开仓库,其额度由该部署上的每一位调用方共同计入——令牌与速率限制讲清了这要付出什么。无论用的是哪个令牌,它都只驱动向上游 GitHub 的调用,别无他用:它绝不写日志、绝不进审计日志、绝不存储,也绝不在响应或错误里回显。
重跑是安全的。 已经导入过的行会按其来源 id 匹配并被跳过,而不是重复。第二次导入会用第一次之后新出现的内容把看板补齐。
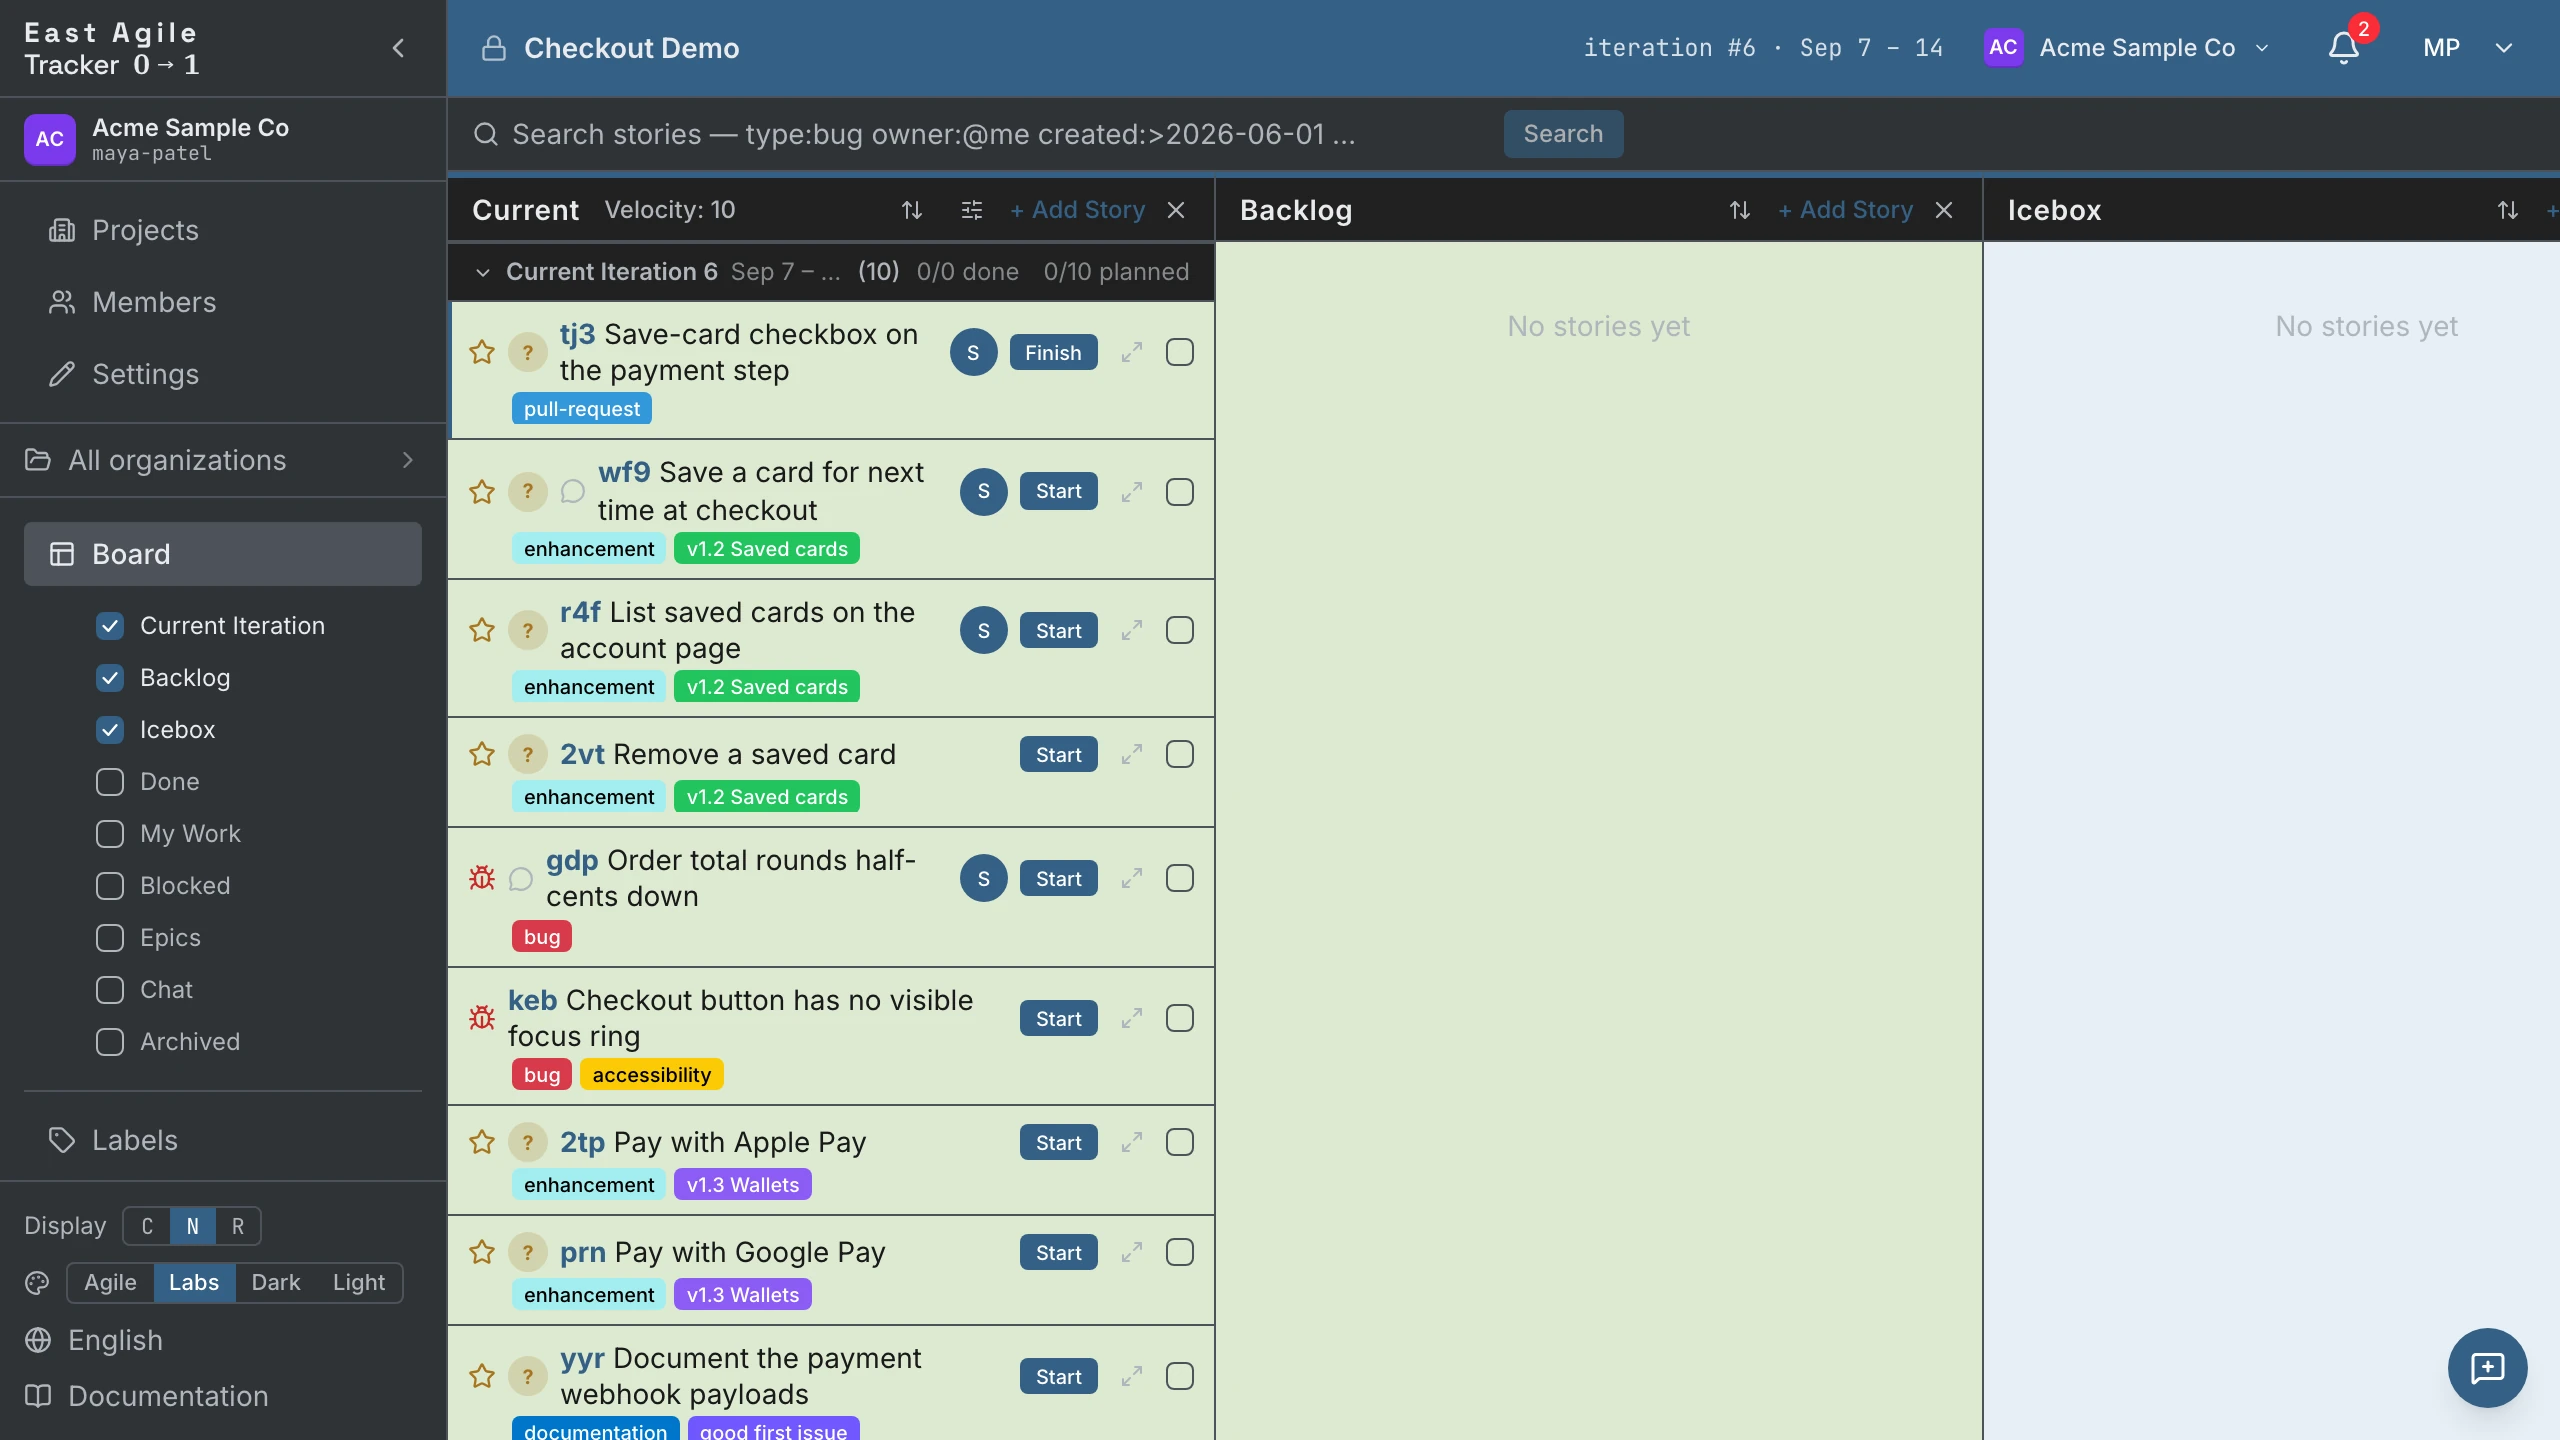
6. 看板上会落下什么
Section titled “6. 看板上会落下什么”issue 默认导入。其余全部为可选启用,每种类型一个开关:
| 来自 GitHub | 变成 | 开关 |
|---|---|---|
| Issue | 一条故事。开启 → Backlog 中的 unstarted。关闭 → accepted;若 GitHub 表明该 issue 以 not_planned 或 duplicate 关闭,则为 rejected(故事随即带上对应标签)。 | 默认 |
| Issue 正文中的清单 | 任务 —— 每一行 - [ ] / - [x] 按正文顺序变成一个任务,[x] 抵达时即为已完成。清单也仍留在描述里。 | 默认 |
| 标签 | 标签,原样带过来。 | 默认 |
| 拉取请求 | 一条带 pull-request 标签的故事。开启 → started,已合并 → accepted,未合并即关闭 → rejected。 | include_pull_requests |
| 里程碑 | 一个以里程碑命名的 epic,按标题去重——共享同一里程碑的两个 issue 会落进同一个 epic。开关关闭时,它改为以 milestone:<标题> 标签随行。 | include_milestones |
| 发布 | 一条 release 故事。已发布 → accepted,草稿 → unstarted。 | include_releases |
| Issue 依赖 | 故事上的一个阻塞项。仅限 issue,绝不包括拉取请求。 | include_dependencies |
当 issue 没有明说时,故事类型会被推断。 含 bug、fix 或 defect 的标签——或者以 fix、bug 开头的标题——会让它成为 bug;chore、maintenance、devops 或 infra 让它成为 chore;其余都是 feature。这值得在导入前就知道,因为在 East Agile Tracker 里只有 feature 带 point,也只有 feature 计入速度。参见介绍 → 故事。
7. 智能体处理一条故事
Section titled “7. 智能体处理一条故事”现在看板上有了历史,智能体也有了密钥。从这里开始,闭环只剩四次调用。
找一条故事,或者写一条。 过滤看板,找点可以接手的活:
curl "https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories?state=unstarted" \ -H "X-TrackerToken: $TRACKER_TOKEN"import_source=github 会把范围收窄到导入带进来的部分。如果智能体发现了仓库从未记录的工作,它就改为创建故事——参见API 指南 → 创建故事。
认领它。 智能体通过 POST 一个空的请求体把自己加为所有者:
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/owners \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{}'空的请求体意味着调用方本身,所以智能体不需要知道自己的 id。看板现在把智能体显示为所有者,旁观的人据此就知道这份工作已经有人接了。
开始它。
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/transitions \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"to": "started"}'接着智能体就去干活——读仓库、写代码、开拉取请求。那部分发生在你的编码工具里,不在这里。
附上拉取请求。
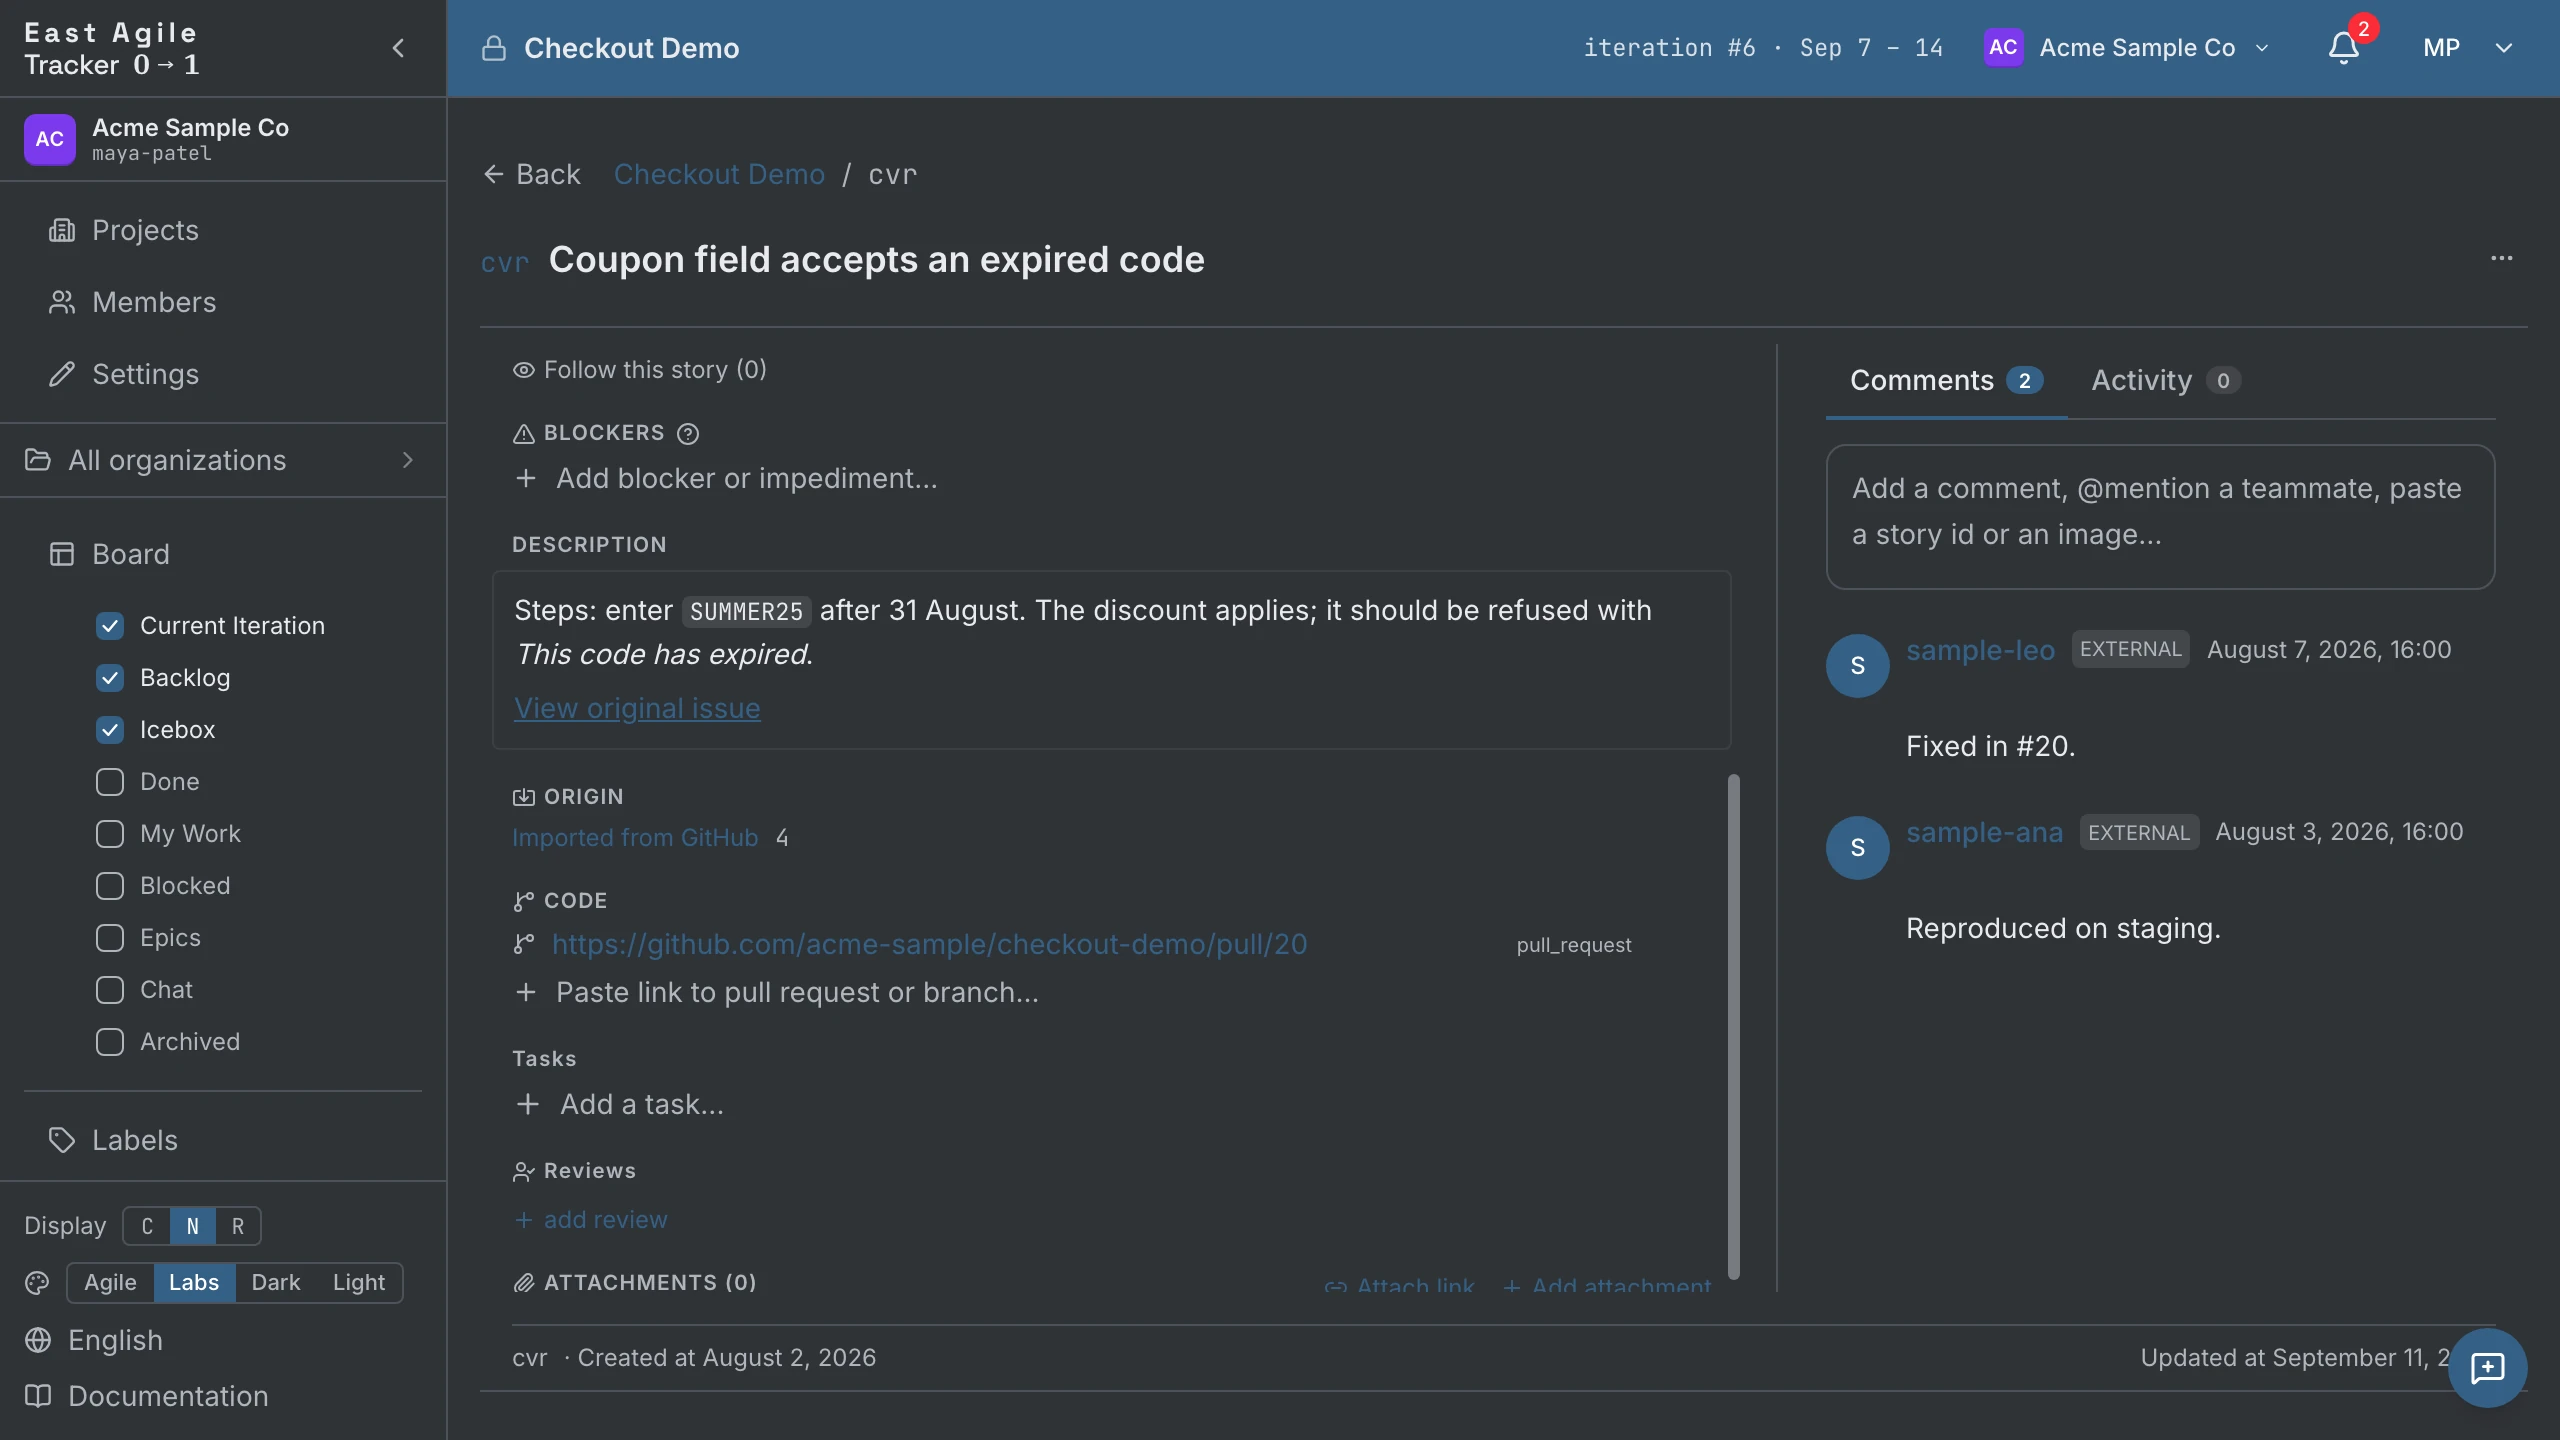
curl -X POST https://eastagiletracker.com/api/v1/projects/$PROJECT_ID/stories/$STORY_ID/links \ -H "X-TrackerToken: $TRACKER_TOKEN" \ -H "Content-Type: application/json" \ -d '{"url": "https://github.com/octocat/hello-world/pull/42"}'GitHub 的拉取请求 URL 会被自动识别——你不必特意说明。故事和关闭它的代码,如今在两个方向上都只隔一次点击。
完成它。 流转到 finished 就停在那儿。feature 前面还有 delivered 和 accepted,那才是评审关口:由智能体以外的人来判定工作是否做对了。chore 没有这道关口——started → accepted 就是它剩下的全部路径。
令牌与速率限制
Section titled “令牌与速率限制”每一次导入都会认证。issue、评论和拉取请求的抓取跑在 GitHub 的 GraphQL API 上,而 GraphQL 拒绝不带令牌的请求——无论公开仓库还是私有仓库,都不存在匿名层级。问题从来不是会不会有令牌发往 GitHub,而只是谁的令牌。
你自己的令牌
Section titled “你自己的令牌”在导入调用里传 token,或给 GitHub-to-EAT 传 --token。一个对该仓库 issue 有读取权限的细粒度个人访问令牌就够了。它只驱动向上游 GitHub 的调用,别无他用:绝不写日志、绝不进审计日志、绝不存储,也绝不在响应或错误里回显。
凡是超出演示的场景,都请自带令牌。这样你花的是别人碰不到的额度,也不会因为别人的导入而在预检时被拒。
--engine direct 不给你选择的余地。那个引擎从你的机器读取 GitHub,而不是经由 Tracker,所以服务器的令牌够不着;一次不带令牌的运行会在抓取或写入之前就以 2 退出,并报出用法错误。你环境或 .env 里的 GITHUB_TOKEN 同样算数,与 --token 等效。
强制要求令牌的是遍历 issue 这一步,而非整个引擎。direct 通过 GraphQL 读取 issue、评论和 pull request,而 GraphQL 没有匿名模式;它只在 releases 列表和免费的 /rate_limit 探测上用到 REST。该工具仍然附带一个较旧的匿名 REST 抓取器,它曾能在每小时 60 次的额度内完成公开仓库的导入,但现在没有任何 CLI 路径能到达它,并且计划将其删除——因此请把 --token 视为 direct 的必需项。
该部署的共享令牌
Section titled “该部署的共享令牌”不发送 token,服务器就换上运行方配置的平台令牌(GITHUB_IMPORT_PAT)。随之而来的有三条限制:
- 它是可选配置。 托管的 eastagiletracker.com 会预置一个,所以在那里不带令牌的公开仓库导入是可用的。自托管安装——你下载的二进制文件——在运维方于环境中设置
GITHUB_IMPORT_PAT之前没有,在那之前它会以400import_github_no_token拒绝每一次不带令牌的导入。 - 它只读公开仓库。 托管服务以只读方式在公开仓库上铸造它,所以私有仓库始终需要你自己的令牌。
- 该部署上的每一位调用方共用一份额度。 在一次不带令牌的导入运行前,服务器会读取共享令牌剩余的 GraphQL 点数,低于 500 就以
400import_github_shared_quota_low拒绝。额度在导入中途耗尽,则作业以import_github_rate_limited_platform失败。两条消息指向同一个解法:提供你自己的令牌。
令牌换来什么
Section titled “令牌换来什么”GitHub 对它的两套 API 分别计量,而未认证时的上限要低两个数量级。
| GitHub API | 用于 | 有令牌 | 无令牌 |
|---|---|---|---|
| GraphQL | issue、评论、拉取请求、子 issue、依赖 | 每小时 5,000 点,按查询返回的节点计分 | 拒绝——GraphQL 没有未认证层级 |
| REST | 发布(include_releases)以及 /rate_limit 预检 | 每小时 5,000 次请求 | 每小时 60 次请求,按 IP 地址计数,并与其后的所有人共享 |
导入绝不会退化到那条每小时 60 次的层级:既然没有令牌可发,请求会在一开始就被拒绝,而不是匿名重试。这个数字真正影响的是你在导入周边做的事——一个直接读取 GitHub 的脚本,或者一个与其他客户端处在同一网络里的 shell,几秒钟就能耗尽 60 次请求。
你随时可以读取自己剩余的额度;GET /rate_limit 不受这两项限制约束,所以这次检查不花任何代价:
curl -H "Authorization: Bearer $GITHUB_TOKEN" https://api.github.com/rate_limitGraphQL 的点数不等于请求数。GitHub 按查询返回的节点计分,所以一页 100 个 issue 连同它们的评论和指派人就要花掉不少点数,而一个大仓库消耗完每小时额度所需的调用次数,远比 REST 时代的数字所暗示的要少。--dry-run(步骤 3)和 dry_run(步骤 4)各自消耗的点数与真实抓取相同——正因如此它们的计数才可信——所以预检一次大规模导入时,请按两趟来预留额度。
接下来看什么
Section titled “接下来看什么”- API 指南 —— 搜索语法、事件流、批量流转、幂等写入,以及其余的接口面。
- 操作说明 —— 从界面执行的同样操作,以及另外十个导入器。
- 介绍 —— 状态机和四种故事类型为何是这个形状。
- GitHub-to-EAT —— 该导入器自己的仓库:每一个开关、两种引擎,以及如何为它贡献代码。